一、为什么 DCMM 三级不是“有平台就够了” 一家准备做 DCMM 评估的企业,最初以为难点在材料准备。制度文件可以补,组织架构可以画,平台功能截图也能凑。但真正进入自查阶段后,问题开始变得具体:数据标准在哪里执行?质量问题发现后谁来修、怎么复验?一张经营报表里的指标能不能追到源系统字段?数据资产目录是不是只有 IT 人员看得懂? 这时团队才意识到,DCMM 三级关注的不是“有没有一个数据治理平台”,而是企业的数据管理能力是否真正运行起来。 DCMM 2.0(GB/T 36073-2025)是企业数据管理能力成熟度评估模型。它关注的是企业在数据战略、数据治理、数据架构、数据资产、数据标准、数据质量、数据安全、数据生存周期、数据应用流通等能力域上的综合成熟度。对于正在建设数据治理平台的企业来说,平台不是评估的全部,却是很多能力从制度走向执行的关键载体。 换句话说,三级评估不会只问“系统里有没有这个菜单”,而会继续追问:这个能力是否被使用,是否有记录,是否能复验,是否能支撑业务。 二、三级评估最容易卡住的四类证据 从平台建设角度看,企业在 DCMM 三级准备中常卡在四类证据上。 证据类型 评估常见追问 平台需要提供的支撑 标准执行证据 标准是否只是文档? 标准编制、发布、落标、执行记录 质量闭环证据 问题发现后谁修、怎么验? 质量规则、监测、告警、工单、复验台账 元数据与血缘证据 数据从哪来、影响到哪? 元数据采集、血缘解析、变更影响分析 资产使用证据 数据是否真的被业务使用? 资产目录、申请审批、API 调用、使用统计 这四类证据背后,其实对应着同一个要求:数据管理能力要从“说得清”走向“做得到”。制度和流程是前提,但如果没有平台把执行过程记录下来,很多能力既难以持续运行,也难以被验证。 三、数据标准要从“写出来”变成“跑起来” 很多企业并不缺数据标准文档。字段命名规范、代码集、指标口径、数据元定义,文件夹里都有。但一到新系统接入,字段仍然按项目组习惯命名;同一个客户、供应商、物料,在不同系统里仍然各有各的说法。 DCMM 三级所要求的数据标准能力,不应停留在“制定标准”,还要能证明标准被执行。落到平台上,至少要能回答三个问题。 第一,标准是否可以在线管理。数据元、代码集、业务术语、指标口径,不能只存在于 Word 和 Excel 里,而应能在平台中被编制、审核、发布和更新。 第二,标准是否能关联到真实数据对象。一个标准字段发布后,能不能关联到对应的数据库表、字段、主题域和数据资产?如果标准和物理数据之间没有关系,标准就很难进入日常开发和治理流程。 第三,标准执行是否有记录。哪些字段已落标,哪些字段未符合规范,整改是否完成,都应形成可追踪的过程。 华东某大型化工企业(企业名称已脱敏)在建设数据中台时,就不是先追求大屏展示,而是先统一物料、产品、指标口径等核心标准。该企业原本 MES、ERP、CRM 等系统相互独立,物料编码不统一,经营分析依赖人工对账。项目中通过建立企业级数据标准管理机制、编制业务术语和指标说明书,为产销协同和经营分析打下了统一语言。 对于数据治理平台来说,数据标准模块的价值不在于“能录入多少条标准”,而在于标准能否进入数据接入、建模、质量检查和资产发布流程。 四、质量管理要形成“发现—定位—修复—复验”闭环 数据质量是三级评估中最容易暴露问题的领域。很多平台可以配置质量规则,也能生成质量报告,但问题在于:报告出来之后怎么办? 如果质量问题只是停留在“发现异常”阶段,治理能力仍然是不完整的。一个更完整的质量闭环,应当包含发现、定位、分派、修复、复验和归档。 这里要特别区分两种模式。部分场景适合前置强校验,例如关键主数据新增时必须符合编码规则。但在大规模数据归集场景中,如果把所有质量检查都做成入库拦截,容易影响数据流转效率。更稳妥的做法通常是旁路监测:数据正常入仓,质量模块并行扫描,发现问题后打标记、告警、生成整改工单,不阻断原有数据链路。 江西某国控集团的案例可以说明这一点。该集团原有协同办公、产权管理、投资管理、财务、人力、党建等 10 余套系统分散独立,监管数据质量无管控,领导难以获得可信的统一数据视图。项目中,平台构建了完整性、准确性、一致性、及时性、唯一性等稽核规则,实现数据自动检测、异常告警、问题定位和整改跟踪。质量管理不再只是“查出问题”,而是进入监管数据的日常运行机制。 DCMM 三级看重的正是这种可持续运行的质量管理能力。规则数量不是关键,闭环是否跑得起来才是关键。 五、元数据和血缘要支撑“可追溯” 当业务部门问“这个指标从哪来”时,如果数据团队只能去翻脚本、问开发、查历史工单,说明元数据能力还没有真正建立。 元数据不是简单的表清单。它至少应包括表和字段的技术信息、业务含义、责任人、更新频率、来源系统、加工过程和下游使用关系。血缘分析的价值也不只是画图,而是帮助团队回答两个问题:数据从哪来,改了以后影响谁。 从平台能力看,元数据和血缘至少要满足三层要求。 第一,基础元数据自动采集。接入数据库后,平台应能自动采集表结构、字段类型、字段注释、数据量等基础信息,减少人工维护成本。 第二,平台内链路自动记录。当数据在平台内完成集成、加工、归集、共享时,输入输出关系应被自动记录,便于后续追溯。 第三,平台外链路允许手动补全。现实中很多企业仍有外部脚本、第三方工具或历史任务。对于平台未覆盖的环节,血缘关系需要支持手动维护节点和连线,不能简单承诺“所有链路一键自动完成”。 江苏某市监局建设数据治理平台时,就把全盘元数据管理作为基础能力之一。平台建立全局统一的数据资源目录,实现元数据自动采集、变更同步和版本追溯,让监管数据资产“看得见、找得到、读得懂”。这类能力是后续质量定位、资产目录和共享服务的基础。 六、资产目录要从“台账”走向“业务入口” 很多企业的资产目录,本质上还是一张技术台账。表名、字段名、库名都有,但业务人员看不懂,也不知道能不能申请、怎么使用。这样的目录很难证明数据资产已经进入业务流通。 在 DCMM 2.0 背景下,数据资产和数据应用流通的重要性进一步提高。数据治理平台如果只管“管数据”,不管“用数据”,能力链条是不完整的。 一个更成熟的资产目录,应具备几个特征:业务语言可检索,数据质量状态可见,权限申请在线化,API 或数据集可以被服务化发布,调用和使用情况可以被统计。 江苏某市监局项目中,平台不仅建设了数据管理能力,还提供自助式 API 服务和统一门户。监管人员日均登录系统次数减少 90% 以上,数据需求响应从天级缩短至分钟级。这个变化说明,资产目录和共享服务不只是“展示数据”,而是在改变业务使用数据的方式。 这也是三级能力建设中容易被忽视的一点:数据治理不是把数据管在平台里,而是让可信数据被业务安全、稳定、可控地使用。 七、用“理采存管用”把三级要求拆成落地路线 DCMM 给出能力目标,但企业还需要一条工程化路径,把目标拆成能排期、能实施、能验收的任务。龙石数据提出的“理采存管用”方法论,可以作为一种落地视角。 理采存管用 对应建设重点 平台动作 理 目标、组织、资产家底 数据资产盘点、治理职责、标准框架 采 数据来源与归集 多源异构接入、全量/增量同步 存 模型与架构 ODS-DW-ADS 分层、主题域模型 管 标准、质量、安全 元数据、主数据、质量规则、分类分级 用 共享和应用 资产目录、API、报表、AI 用数 需要说明的是,这是一种工程实施视角下的对应关系示意,并不是将 DCMM 能力域与产品模块做严格的一一对应。比如“理”不仅包含战略规划,也涉及组织、制度和资产盘点;“管”也不只是质量规则,还包括标准、主数据、安全和责任闭环。 部分数据治理平台,例如龙石数据中台,会将标准管理、数据质量、元数据、资产目录、API 服务等模块组织在同一套方法论下。对于准备 DCMM 三级评估的企业来说,选型时不应只看模块名称,而应看这些模块能否串成一条可执行的治理流程。 八、FAQ Q1:DCMM 三级是不是只要买数据治理平台就能过? 不是。平台只能提供执行、留痕和复验能力,组织、制度、责任机制仍然需要企业自己建立。没有治理组织和业务责任人,平台里的流程也跑不起来。 Q2:平台演示时应该重点看什么? 建议用一条真实数据链路做验证:从数据接入、标准关联、质量监测、问题定位,到资产发布和业务申请。能跑完一条闭环,比看完整功能清单更有价值。 Q3:旁路监测会不会影响数据入库效率? 旁路监测的设计是不阻断入库。数据正常入仓,质检并行扫描,发现问题后生成告警和整改任务。它适合在不改业务系统的前提下建立持续质量治理机制。 Q4:三级建设从哪里开始比较稳妥? 较为稳妥的做法是先选择一个高价值数据域,完成标准、质量、元数据和资产目录的最小闭环。跑通后,再横向扩展到更多业务域。 参考来源 国家市场监督管理总局、国家标准化管理委员会,《数据管理能力成熟度评估模型》(GB/T 36073-2025) DAMA International,《DAMA-DMBOK: Data Management Body of Knowledge》 GB/T 36344-2018《信息技术 数据质量评价指标》

一、选型误区:为什么看了十几家厂商还是选不对? 一位制造企业的CDO在选型三个月后,在一次内部复盘会上说了这样一段话: "每家厂商的PPT都差不多——功能列表两百多项,DAMA、DCMM这些词都在封面上挂着。但我想知道的是:你们的元数据采集是自动的还是手动的?数据质量规则怎么配?标准落标是怎么做的?一问这三个问题,三家厂商的回答几乎一样——'这个我们支持,具体要看实施配置'。" 他停顿了一下,补了一句更让人难受的话:"后来我才意识到,我问的问题,和厂商回答的'支持',根本不在一个频道上。" 这个场景折射出数据中台选型中一个普遍困境:功能列表高度同质化,每家都写着"支持数据治理""支持数据质量""支持元数据管理",但"支持"这个词覆盖的范围可以从"系统里有个菜单"到"全自动采集+闭环追溯"——差距大到足以决定项目成败。 根据我们在实际选型咨询中观察到的案例,以下三个陷阱最具代表性: 陷阱一:功能列表越长越好。 某中型汽车零部件企业投入200余万元采购了一套"一站式AI数据平台",功能清单超过230项。上线三个月后,数据质量模块仅配置了不到20%的规则,元数据采集仍需手工录入。功能列表的长度不等于功能落地的深度——买了一套百科全书,不等于学会了里面的知识。 陷阱二:POC跑通等于项目能落地。 厂商演示环境的数据干净、规范、标准化——这是精心准备过的。但真实的IT环境里,异构系统、脏数据、编码混乱才是常态。POC跑通只能证明"理想条件下产品功能可用",不能证明"你的环境里产品能持续运转"。选型时如果把POC当终审,上线后面临的第一个问题往往是"为什么演示时跑得通,我的数据一进去就报错"。 陷阱三:选型只看功能不看组织匹配。 DAMA数据管理知识体系开篇就强调了一条原则——"数据治理首先是组织治理"。数据中台选型不只是选一个技术平台,更是选择一个未来几年支撑数据管理组织运转的基础设施。选型时不评估厂商能否帮你建立数据治理的组织能力,等于买了一把好刀但没人会用——工具再锋利,还是切不动。 这三个陷阱指向同一个根因:缺少一套标准化的评估语言。 功能列表是厂商写的,POC环境是厂商搭的,组织匹配的判断标准是模糊的。选型者需要的不是一个更长的检查清单,而是一把第三方标尺。 二、评估框架:DAMA凭什么能做选型标尺? 2.1 DAMA是什么 DAMA(国际数据管理协会)发布的《DAMA-DMBOK数据管理知识体系指南》被广泛视为数据管理领域的"百科全书"。它不隶属于任何厂商,而是一个由全球数据管理从业者共同维护的开放知识体系。其官方定义清晰界定了数据管理的范畴: "Data Management is the development, execution, and supervision of plans, policies, programs, and practices that deliver, control, protect, and enhance the value of data and information assets throughout their lifecycles." 简言之:数据管理是围绕数据全生命周期,开展规划、执行和监督的制度、流程与实践活动。这个定义本身就隐含了选型的关键视角——你不是在选一个软件,而是在评估一个产品能否支撑完整的制度、流程与实践活动。 DAMA-DMBOK将数据管理能力划分为11个知识领域:数据治理、数据架构、数据建模与设计、数据存储与操作、数据安全、数据集成与互操作、文档与内容管理、参考数据与主数据、数据仓库与商业智能、元数据管理、数据质量。这11个领域覆盖了数据管理从组织到技术、从规划到运营的完整拼图。 2.2 为什么用DAMA做选型标尺 在数据中台选型中,常见的三种"标尺"各有缺陷: 选型方式 典型做法 核心缺陷 看功能列表 对比各厂商功能清单,按"有/无"打分 "支持"的深度差异巨大——菜单里有不等于真能用 看案例数量 数厂商PPT里的客户Logo数量 "做过"不等于"做成了",更不等于"适合你" 看技术栈 评估数据库、计算引擎、中间件 技术是必要条件,不是充分条件——技术强≠治理能力强 DAMA作为标尺的优势在于三个"不":不是厂商标准——没有哪个厂商能说自己"定义了DAMA";不是功能列表——每个知识领域对应的是一个能力体系而非一个菜单项;不是静态框架——11个领域之间有内在联系,能帮你看到产品的系统性而非单点功能。 用DAMA做选型评估,本质上是把"这个产品有什么功能"的问题转化为"这个产品在DAMA的每个知识领域下,能力深度到了什么程度"。前者是厂商视角,后者是用户视角。 2.3 DCMM 2.0:国内标准的补充 DAMA是国际标准,告诉你"该建什么能力"。作为补充,中国国家标准DCMM 2.0(GB/T 36073-2025)即将于2026年7月1日正式实施,告诉你"建到了什么水平"。DCMM 2.0相比1.0版本(GB/T 36073-2018)有一个关键变化:能力域从8个扩展为9个,新增了"数据资产"能力域,将数据资产目录、数据资产化等要求提到了与数据质量、数据安全同等的高度。 DAMA和DCMM的关系可以这样理解:DAMA是能力地图,DCMM是水平刻度。 选型时先用DAMA的11个知识领域做能力覆盖评估,看产品是否具备应有的能力模块;选型后可以用DCMM 2.0的九大能力域做成熟度自评,规划后续的能力提升路径。两者结合,构成了从能力定义到成熟度评价的完整选型框架。 2.4 DAMA 11个知识领域全景速览 以下将DAMA 11个知识领域与数据中台选型要检查的核心问题逐一对应: DAMA领域 核心问题 选型要检查什么 数据治理 谁决策、谁负责、怎么考核? 权限体系是否覆盖"管/建/用"全链路、治理流程能否数字化闭环 数据架构 数据怎么组织、怎么流动? 是否支持分层建模、模型即执行、多数据域独立管理 数据建模与设计 概念模型→逻辑模型→物理模型能否贯通? 数仓分层是否可灵活配置、模型定义和执行是否一体 数据存储与操作 数据存在哪、怎么管? 存储引擎兼容性、私有化部署、信创适配 数据安全 谁能看、谁能改、谁能导出? 分类分级、脱敏策略、权限粒度 数据集成与互操作 不同系统怎么通? 多源异构接入、流批一体、标准化接口 参考数据与主数据 核心实体能不能统一编码? 编码规则定义、多系统映射合并、变更同步 元数据管理 数据从哪来、什么意思? 自动采集能力、血缘分析跨系统追踪 数据质量 数据准不准、全不全? 规则配置方式、闭环追溯机制、是否非侵入 数据仓库与商业智能 分析和报表怎么支撑? 自助分析、可视化、业务人员学习成本 文档与内容管理 非结构化数据怎么管? 知识库、文档管理、非结构化数据处理能力(选型次优先级) 上述11个领域中,"文档与内容管理"在数据中台选型中优先级较低(通常由独立的ECM/知识管理系统承载),其余10个领域均是选型评估的核心维度。下文将10个领域进一步合并为7个可操作的评估维度,从基础能力到治理能力到应用能力逐层展开。 三、关键维度(上):基础能力四维检查 本章覆盖DAMA框架中与"数据如何进来、存在哪里、怎么组织"相关的四个基础维度。这四个维度决定了数据中台的"底盘"稳不稳。 维度一:数据治理——组织能力,不是"权限管理"菜单 DAMA将"数据治理"列在11个知识领域的第一位,定义为"对数据资产行使权力与实施管控的权威体系,涵盖问责机制与决策权的分配"。翻译成选型语言就是:产品能不能支撑一个数据治理组织的运转。 很多数据中台产品在"治理"这个维度上的交付物是"用户管理"+"角色管理"两个菜单。这是技术权限,不是治理组织。DAMA意义上的数据治理,需要回答的是:谁对数据质量负责?谁审批数据标准变更?谁管理数据资产目录?这些问题不是靠RBAC权限模型能解决的。 DAMA要求 选型检查项 实操验证方法 治理组织和制度建设 产品是否支持多角色分权?角色体系是否覆盖"管/建/用"全链路? 要求在系统里创建一个"数据质量管理员"角色,指定其管辖范围(如仅负责某数据域),看是否能实现 治理流程数字化 质量问题从发现→分配→修复→验证,能否在平台内形成完整闭环? 要求演示一个完整的数据质量工单流程——发现问题→指派责任人→修复→自动复验→关闭 核心判断标准:如果一个中台的治理能力只能用"用户管理"+"角色管理"两个功能来描述,那它做的是技术权限而非治理组织。DAMA意义上的治理能力应当具备三个基本特征:角色可定义、流程可闭环、责任可追溯。 维度二:数据架构——模型在系统里跑,不在PPT里 DAMA对数据架构的定义包含"企业数据模型"和"数据流设计"两个子领域,核心问题是:数据的组织结构和流转路径是怎么设计的,这个设计能不能直接落地为系统行为。 一个在选型中常见的信号:厂商在PPT里展示了精美的分层架构图(ODS→DW→ADS),但当你要求打开产品界面实际创建一个数据分层时,对方说"建模需要单独的工具"或者"这个需要定制配置"。这意味着模型在设计文档里,不在系统里。模型和实际存储是分离的,后续运维靠人工保持一致。 DAMA要求 选型检查项 实操验证方法 数据模型设计 是否支持ODS-DW-ADS分层建模?分层是否可灵活配置? 看数据规划模块能不能直接在界面上创建分层、定义各层的存储策略和生命周期 数据流转和分布管理 是否支持多数据域的独立建模和管理? 要求创建两个不同的数据域(如"生产域"和"供应链域"),分别建立分层模型,看能否互不干扰地独立运作 核心判断标准:好的数据架构产品应该做到"模型即执行"——在平台上定义的分层、模型、字段约束,就是数据实际存储和计算的结构。如果一个产品的架构设计能力只存在于设计文档中,选型时就应该亮起黄灯。 维度三:数据集成与互操作——能不能接得住你的异构环境 DAMA将数据集成定义为"管理数据在数据存储、应用和组织之间的移动和整合"。这个维度在选型中的核心问题是:产品能不能跟你现有的IT环境真正打通,而不是要求你迁就它。 现实中,甲方常见的数据库品牌组合可能包括Oracle、MySQL、SQL Server、PostgreSQL、达梦、人大金仓、OceanBase等七八种。某些行业的OT层还有工业实时数据库(如PI System)。一个中台产品对这些数据源的真实兼容性,直接决定了接入阶段的工程量。 DAMA要求 选型检查项 实操验证方法 多源异构数据汇聚 支持哪些数据库类型?信创数据库(达梦/人大金仓/OceanBase等)适配了吗? 列出你现有的数据库清单,逐项对照厂商的兼容列表,最好在POC阶段用真实库验证 实时+批量采集 是否支持流批一体?增量同步怎么配? 现场配一个MySQL→中台的增量同步任务,指定同步频率和过滤条件,看实际运行效果 接口标准化 数据接入是用标准协议还是私有协议?能不能对接已有的ETL工具(如DataX/Kettle)? 确认产品是否有标准API支持第三方ETL写入,不接受"我们可以定制开发"的话术 核心判断标准:数据集成能力最怕"伪兼容"——列表里写着支持,实际接入时遇到分库分表、大字段、特殊字符集就出问题。POC验证时不要用厂商准备的标准测试库,用你的真实数据库做一次全量+增量接入,观察运行稳定性。此外特别提示:如果一个中台只能用自己的采集工具、无法对接你现有的DataX/Kettle等ETL设施,那不是在帮你整合数据,而是在为你增加新的技术债务。 维度四:数据存储与操作——信创是硬门槛 DAMA中数据存储与操作涵盖"数据库管理"和"数据技术基础设施管理"。在中国企业的实际选型中,这个维度的核心议题已经收敛为一个词:信创。 《数据安全法》2021年9月实施后,数据存储层的安全合规从"加分项"变为"一票否决项"。对于国企、政府和关键基础设施行业,中台产品是否完成信创适配认证已成为选型的硬性门槛。 DAMA要求 选型检查项 实操验证方法 存储选型和运维 支持哪些存储引擎?是否支持私有化部署? 确认产品可脱离公有云独立部署,了解最低硬件配置和部署周期 信创适配 操作系统(麒麟/统信)、CPU(鲲鹏/飞腾/海光)、数据库(达梦/人大金仓/OceanBase)是否完成兼容性认证? 要求提供正式的兼容性认证证书,优先安排在信创环境做POC验证 核心判断标准:信创适配不是"预留了适配接口"就够了。认证列表长不等于适配好——验证过才算数。POC阶段用信创环境跑一遍,比任何认证证书都有说服力。另一个需要关注的点是部署灵活性:是否支持从单机起步(如16C32G),后续再横向扩展,这对于预算有限的中型企业尤为关键。 四、关键维度(下):治理能力三维检验 上一章解决了数据"进得来、存得住、组织好"的问题,本章聚焦三个治理能力维度——它们决定了中台能不能让数据"管得住、信得过、用得上"。其中数据质量是整个评估框架中最关键的一环。 维度五:数据质量——能建规则,更能追源头 数据质量做不好,后面的主数据、元数据、BI分析都是空中楼阁。DAMA将数据质量管理定义为"规划、实施和控制活动,运用质量技术来衡量、评估、提升和确保数据在组织内的适用性"。这个定义传递了一个关键信息:数据质量不是一次性的"清洗",而是一个持续运营的过程。 在选型中,评估一个产品的数据质量能力,比单纯的"支持多少条质量规则"重要得多的是:它能不能形成"定义规则→运行监测→发现问题→追溯源头→修复数据→自动验证"的完整闭环。 DAMA要求 选型检查项 实操验证方法 质量需求与检查 质量规则是只能技术配置,还是业务人员也能参与? 要求厂商用你的业务逻辑当场配一条"物料主数据空值率"规则,看需要几步操作 质量分析与提升 发现问题后,能不能追溯到源系统、源表、源字段?修复后能不能自动重新验证? 演示:发现一个质量问题→一键追溯到源系统的哪张表哪个字段→修复→重新扫描验证 非侵入监测 质量检查会不会阻塞数据正常入库? 确认是旁路监测模式——数据正常流入,质检引擎并行扫描,不增加入库延迟 核心测试方法:拿一个你真实的业务痛点——比如"同一客户在三个系统里名字不一致",让厂商现场演示从定义规则到生成质量报告的全流程。这个测试比任何功能列表都有说服力。 实践对照:上海某大型化工企业在选型时重点验证了数据质量的闭环能力。该企业MES/ERP/CRM系统割裂,物料编码不统一,OT生产数据与IT业务数据未打通。选型后通过数据中台建立统一物料编码体系和数据质量闭环管理机制,实现库存周转率提升28%,订单交付及时率提升至91%,报表出具周期提前4天。这个效果的前提是:选型时把质量闭环能力验证透了,而不是看功能列表里打了几个勾。 维度六:主数据与元数据——数据的"身份证"和"地图" 主数据和元数据在DAMA框架中分属两个独立的知识领域,但在选型评估中建议放在一起看——因为它们共同回答了数据使用的两个基本问题:"这个实体到底指什么"(主数据),以及"这个数据从哪来"(元数据)。 主数据管理解决的是核心业务实体的一致性。主数据不统一,一切分析都是错的。 选型检查项 实操验证方法 是否支持主数据标准定义(编码规则、值域约束)? 创建一个"供应商"主数据标准,配置编码规则和必填字段校验 多系统主数据能不能做映射和合并? 演示:CRM系统里的"XX科技有限公司"和ERP系统里的"XX科技"怎么自动匹配为同一实体 主数据变更能不能同步到下游系统? 修改一条主数据的属性值,观察下游消费系统能否自动接收更新 实践对照:江苏某建筑装饰集团旗下200余家子公司,选型时将主数据统一能力作为第一优先级。此前因物料/供应商/项目部编码不统一,跨公司对账需要5天,数据纠纷频发。通过中台统一物料、供应商、项目部编码后,跨公司对账周期压缩至1天,数据纠纷减少80%,项目平均工期缩短约10%。这个案例的关键启示是:集团型企业的选型评估中,主数据的"多租户统一管控"能力应当排在功能列表的第一页。 元数据管理解决的是数据的"说明书"和"家谱"——这个字段是什么意思、从哪个系统来的、经过哪些加工、被哪些报表使用。 选型检查项 实操验证方法 元数据采集是全自动还是需要手工录入? 接入一个包含50张表的关系型数据库,看几分钟内能自动采集多少元数据(表结构、字段、注释、主外键关系) 血缘分析能不能跨系统追踪? 选一个BI报表上的指标字段,要求追溯它从源系统到报表的完整加工路径,看是否自动生成血缘图谱 核心判断标准:元数据采集如果是手动的,那和Excel管理没有本质区别。好的中台应该做到"接入数据源→自动采集元数据→自动生成血缘关系",人工只需做审核和补充。另一个容易被忽视的检查点是:元数据变更时(如源表新增字段),能否自动增量扫描和更新,而不是全量重采。 维度七:数据应用与共享——中台好不好,最终看"用" 中台的终极考验不是"接了多少数据",而是"业务部门用不用"。DAMA框架中的"数据仓库与商业智能"领域,到DCMM 2.0中进一步扩展为"数据应用流通"域——强调数据不仅要能分析,还要能共享、能流通、能被业务人员自助使用。 DAMA/DCMM要求 选型检查项 实操验证方法 数据仓库与BI 是否支持自助分析和可视化? 让一个不懂SQL的业务人员试试能否拖拽生成图表,看学习成本 数据共享 能否自助将查询发布为API?是否有调用监控和流控? 演示:写一个SQL查询→发布为标准API→设置调用次数限制→查看API调用监控面板 数据资产目录 业务人员能不能用业务语言搜索到数据? 用"客户360视图""本月销售额"等业务语言搜索,看能否快速定位到相关数据资源 AI能力(DCMM 2.0新要求) 是否支持自然语言问数? 输入"本月销售额最高的三个产品是什么",看能否自动生成图表和解读 核心判断标准:如果数据资产目录只是一个IT人员看的元数据列表,业务人员仍需要在工作群里@IT"帮我找一下XX数据",那中台的"最后一公里"没通。数据中台的终极价值出口不是"接进来",是"用出去"。 另外一个值得特别关注的新维度是AI用数能力。DCMM 2.0在"数据应用流通"域中强调了数据应用的便利性和智能化水平。选型时可以增加一个测试项:能否通过自然语言查询数据,让非技术用户也能自主获取数据洞察。这个能力将成为未来三年区分数据中台代际的关键指标。 五、案例验证:从选型到落地的两段真实路径 理论框架讲完了,下面用两个真实案例还原DAMA评估框架在选型中的实际运用——重点是验证了什么、淘汰了什么、为什么。 5.1 上海某大型化工企业:选型时验证的三个关键场景 企业背景:MES/ERP/CRM三大系统割裂运行,OT层(生产实时数据)与IT层(管理数据)长期未打通。物料编码在三个系统中各不相同,月度经营会上需要花半小时争论"哪个数字是对的"。 选型中重点验证了三个DAMA能力的深度: 数据质量闭环(对应DAMA数据质量域):不是简单验证质量规则数量,而是要求厂商用企业真实的一个质量痛点(物料空值率),现场跑通"定义规则→全量扫描→定位到MES工位→修复→重新扫描验证"的完整闭环。这一个测试淘汰了用"质量规则需要写SQL"方式实现的产品——如果一个质量规则都需要技术人员写代码来配置,业务人员永远不可能参与质量治理。 OT/IT融合能力(对应DAMA数据集成域):要求同时对接DCS实时数据库和ERP管理数据库,验证不同协议、不同数据结构的统一接入能力。这个测试淘汰了只能做标准JDBC接入的产品——工业企业的选型如果忽略了OT层,注定是半截工程。 主数据统一(对应DAMA主数据域):验证能否在保留各系统原有编码的前提下建立统一的物料编码映射表,实现历史数据对照和新数据统一赋码。 选型结果与落地效果:最终选定的方案支撑企业完成了物料编码统一、OT/IT数据融合和质量闭环管理。库存周转率提升28%,订单交付及时率提升至91%,报表出具周期提前4天。更重要的是,企业同步成立数据管理部,将数据治理纳入绩效考核体系——印证了DAMA强调的"数据治理首先是组织治理"。 5.2 某省级城投集团:一次POC淘汰了三家厂商 企业背景:集团下辖12家子公司,总部希望统一管控数据标准和数据资产,但子公司要求保留各自的数据管理自治空间。典型的"管得住"与"放得开"的矛盾。 选型硬性标准(对应DAMA数据治理域+数据架构域): 工作空间模型:能否在总部定义一套统一的数据标准的同时,允许每家子公司独立管理自己的数据资产目录和权限体系?——这个需求对应DAMA中"数据治理"域的组织分权要求。 多租户架构:是否支持"一集团一中台、一公司一空间"的部署模式?——这对应DAMA中"数据架构"域的数据分布管理要求。 POC验证过程:集团要求四家候选厂商在同一套环境里完成三个测试:①创建集团级数据标准和12个子公司的独立工作空间;②在集团标准约束下,子公司自主配置自己的质量规则;③跨子公司数据共享要有审批流和权限隔离。 结果:三家只能做单体部署的厂商被淘汰——他们的架构逻辑是"一个中台实例服务一个组织",无法原生支持总部统一标准与子公司数据自治的双重要求。最终选定的方案上线后,后续推广从"总部推不动"变成了"子公司主动要求接入"。 选型启示:集团管控场景的选型评估如果只检查技术架构(用什么数据库、用什么部署模式),而不检查组织架构适配性(能不能支持多层级的治理组织),后面一定会出问题。DAMA框架中"数据治理"域和"数据架构"域在集团场景下需要合并评估——治理组织的分层和数据架构的分层是一一对应的。 六、选型工具:一张DAMA评估清单 6.1 DAMA×选型评估清单 以下将DAMA核心知识领域浓缩为一张选型评估清单,每个领域给出权重、必问的关键问题以及需要警惕的红色信号。这张清单可以打印出来,在厂商交流和POC验证时逐项对照。 DAMA领域 评估权重 必问的3个问题 红色预警信号 数据治理 ⭐⭐⭐⭐⭐ ①支持几级治理组织?②数据问题工单能否闭环?③治理流程是否可自定义? 只有"用户管理+角色管理"两个菜单 数据架构 ⭐⭐⭐⭐ ①模型设计是设计即执行吗?②支持多数据域吗?③分层逻辑可灵活定义吗? "建模需要单独的工具" 数据集成 ⭐⭐⭐⭐ ①支持你的全部数据库类型吗?②支持流批一体吗?③有标准API对接已有ETL吗? "我们可以定制开发接口" 数据存储 ⭐⭐⭐ ①信创认证证书齐了吗?②私有化部署最低配置是多少?③支持哪些存储引擎? "适配认证在申请中" 数据安全 ⭐⭐⭐⭐ ①支持数据分类分级吗?②脱敏规则可业务化配置吗?③权限能到行列级吗? 安全功能需要"单独购买安全模块" 数据质量 ⭐⭐⭐⭐⭐ ①质量规则闭环能做到头尾贯通吗?②能追溯到源表源字段吗?③入库链路是非侵入的吗? "质量规则需要写SQL" 主数据+元数据 ⭐⭐⭐⭐ ①元数据采集全自动吗?②血缘跨系统吗?③主数据变更能同步下游吗? "元数据需要手工录入" 应用与共享 ⭐⭐⭐⭐ ①业务人员能自助查数吗?②能自助发布API吗?③支持自然语言问数吗? "数据需要用我们的BI工具才能分析" 6.2 评估框架下的产品选择 在选型实践中,方法论驱动的产品往往对DAMA框架的覆盖更系统。部分产品如龙石数据中台基于"理采存管用"五阶方法论,将DAMA的11个知识领域映射为可独立部署的模块——数据治理、数据质量、元数据管理、主数据管理等均可按需装配。其旁路监测质量管控模式允许数据正常入库的同时并行质检,不影响业务运行。对于集团管控场景,"一集团一中台、一公司一空间"的工作空间模型,满足了总部统一标准与子公司数据自治的双重需求。从单台16C32G即可起步的部署灵活性,也降低了初次选型的试错成本。 七、选型建议与FAQ 7.1 选型路径建议 第一步:先用DAMA自评。 选型前,对照DAMA 11个知识领域做一次快速自评——哪些域你已经有基础了(比如数据集成),哪些域是空白(比如元数据管理),哪些域是痛点(比如数据质量)。这个自评一周内就能完成,但能帮你避免方向性错误——选一个你不需要的能力堆砌的产品,或者漏掉你真正需要的关键能力。 第二步:按紧迫性排序,不要追求11域全覆盖。 大多数企业从"数据集成+数据质量+主数据"三个域起步就能看到明显成效。这三个域跑通后,元数据管理和数据应用自然会提上日程。一次性追求全领域覆盖,预算压力大、实施周期长、失败风险高。 第三步:POC验证三个核心场景,而非跑一遍功能演示。 三个最关键的POC验证场景:①数据质量闭环——一定要用你的真实数据和真实痛点来跑;②元数据自动采集+血缘分析——接入一个真实数据库→扫表→出图谱→验证血缘准确性;③多组织架构适配——建空间→分权→隔离验证。这三个场景跑通,选型的基本面就验证完了。 第四步:服务模式比License价格更重要。 选型不止选产品,更是选未来几年的技术伙伴。厂商是否提供培训+陪跑机制,决定了中台能不能从"工具"变成"能力"。一个按项目交付然后离场的厂商,和一个愿意陪你把第一个业务域跑通的厂商,长期差异远大于初次报价的差距。数据中台不是项目,是能力——这个判断应该贯穿选型始终。 7.2 FAQ Q1:DAMA 11个领域,选型时需要全部检查吗? 不需要全部做深度验证。建议重点检查5个核心域:数据治理(组织匹配)、数据质量(闭环能力)、主数据(统一编码)、元数据(自动采集+血缘)、数据集成(异构接入)。这五个域是DCMM三级能力的基础,也是数据中台区别于传统数据仓库的核心差异点。文档与内容管理、数据建模与设计两个域可以合并评估或在二期扩展时再关注。 Q2:厂商说"我们支持DAMA",怎么验证? 听其言不如观其行。让厂商当场演示三个超越PPT的场景:①接一个你的真实数据库(不要厂商准备的干净库),看元数据自动采集的实际效果,注意采集完整度和耗时;②配一条针对你真实数据痛点的质量规则,跑监测→追溯→定位源系统→给出修复建议;③用业务语言搜索一个数据资源(如"客户360"),看资产目录能不能帮非技术人员找到。演示结果比任何DAMA认证更有说服力——因为DAMA本身不设产品认证,厂商口中的"支持DAMA"需要你用这三个场景来检验。 Q3:中小企业预算有限,怎么用DAMA框架选型? 看模块化和启动成本。优先验证"数据集成+数据质量"两个域——这两个域是最容易在短时间内看到效果的。选型时确认产品是否支持模块独立部署:先上最紧迫的模块,跑通业务场景验证效果,再按需扩展。另外关注部署的最小配置要求——部分产品如龙石数据中台从单台16C32G即可起步,部署周期约一周,适合不想一次性大投入、希望先验证再扩展的企业。 Q4:DCMM 2.0和DAMA在选型中怎么配合使用? DAMA是能力地图(国际标准→告诉你该建什么能力),DCMM 2.0是水平刻度(国家标准→告诉你建到了什么水平)。选型前用DAMA做能力覆盖评估,确保选的产品在关键域上"有"能力;选型后用DCMM 2.0的九大能力域做成熟度自评,规划从"稳健级"到"量化管理级"的提升路径。DCMM 2.0新增的"数据资产"能力域特别值得关注——它提示在选型时就应评估产品的数据资产目录和资产化服务能力,避免上完中台后还要另起一套资产管理系统。 参考来源: DAMA International.《DAMA-DMBOK: Data Management Body of Knowledge》. 2nd Edition. Technics Publications, 2017. 国家市场监督管理总局, 国家标准化管理委员会.《数据管理能力成熟度评估模型》(GB/T 36073-2025). 2025. 全国人民代表大会常务委员会.《中华人民共和国数据安全法》. 2021年9月1日施行.

一、行业背景:治理做了一堆,为什么资产化还是走不通 "我们数据中台建了两年,治理规则配了几十条,数据质量报告月月出。但老板问了一句'这些数据到底值多少钱,能不能入表'——会议室又安静了。" 这不是段子。过去三年里,这个场景在太多数据团队反复上演。 一个值得关注的现象:过去三年上线数据中台的企业数千家,而真正完成数据资产入表的不过数十家。差距背后不是技术跟不上——是多了一道很多企业没跨过去的坎:从"数据治理"到"数据资产化"之间,缺了一条清晰的工程落地路径。 三个政策信号正在把这道坎推到台前。 第一,国家标准升级。 DCMM 2.0(GB/T 36073-2025)将于2026年7月正式实施,能力域从8个扩展到9个,新增"数据资产"能力域。这是一个标志性变化——数据管理能力的评判标准,已从"有没有治理"正式升级为"能不能资产化"。 第二,财务制度落地。 财政部《企业数据资源相关会计处理暂行规定》(财会〔2023〕11号)已施行两年,数据资产入表从试点走向扩面。当CFO开始追问"数据能不能入表",数据治理就不再只是IT部门的内部工作。 第三,要素市场提速。 国家数据局"数据要素×"三年行动计划进入收官年,数据要素市场化配置从政策设计走向落地执行。 三件事指向同一个结论:企业数据管理的主线任务,已经从"建好中台、管好数据"变成了"把治理成果转化为可计量、可入表、可流通的数据资产"。 但问题恰恰卡在这里。多数企业的现实是:数据中台建了、数据接进来了、数仓搭好了——一到"资产化"这一步就推不下去。不是治理没做,而是治理和资产化之间缺了一条清晰的实施路径。治理做了多少才算"够"?什么条件满足才能谈入表?从哪一步开始、按什么顺序走? 本文提出的"理采存管用"五步路径,就是回答这些问题的一条工程化施工图。 二、标准体系:DCMM、DAMA与"理采存管用"的三角关系 要理解治理到资产化的路径,先得看清楚三座"导航塔"各自在说什么。 2.1 DCMM与DAMA:两套框架,一个方向 DCMM(数据管理能力成熟度模型) 是中国的国家标准(GB/T 36073-2025),它将企业数据管理能力划分为9大能力域,每个域分5个成熟度等级。DCMM的核心价值是"评估"——它能告诉企业:你的数据管理能力到了什么水平、和同行比排第几。 DAMA-DMBOK(数据管理知识体系) 是国际数据管理协会的知识框架,涵盖11个知识领域。DAMA的核心价值是"指导"——它告诉企业:数据全生命周期中应该管理什么、每个领域有哪些最佳实践。 两者共同指向一个方向:数据管理的终极目标,是让数据成为可信任、可计量、可使用的资产。 2.2 DCMM 2.0新增"数据资产"域意味着什么 DCMM 1.0的8个能力域聚焦的是"过程"——战略有没有、治理组织建没建、架构清不清晰、标准落没落。这些都是在问"管得好不好"。 DCMM 2.0新增"数据资产"能力域,把焦点从"过程"转向了"结果"——企业不仅要证明"我们有数据治理体系",更要证明"治理产生了可信可用的数据资产"。 对企业的影响很直接:以后做DCMM贯标评估,评估师会追问"你们的数据资产有多少、质量怎么样、目录建了没有"。这不是一份PPT能回答的问题——需要实打实的资产盘点、质量评估和目录管理成果。 2.3 "理采存管用"在这张地图上的位置 如果把三者的关系说得直白一些: DCMM说"管什么"——9大能力域给出了企业管理数据资产的标准化检查清单 DAMA说"该做什么"——11个知识领域给出了数据管理的理论框架和最佳实践 "理采存管用"说"怎么落地"——五步工程路径给出了从数据资源到数据资产的具体施工图 一个是目标(国标定等级),一个是知识(框架定范围),一个是路径(方法论定落地)。三者不是替代关系,而是逐层递进:标准告诉你应该达到什么水平,知识体系告诉你每个领域该做什么,工程路径告诉你从哪开始、按什么顺序、分几步走。 三、大白话:用经营企业的方式理解"理采存管用" 如果把数据资产化类比为经营一家企业,"理采存管用"就是五个核心动作: 阶段 资产化动作 说白了就是 理 数据资产盘点,摸清家底 盘库存——先搞清楚自己有什么 采 多源数据汇聚,打通系统 打通供应链——把货都收到仓库里 存 标准化数据模型,统一口径 建标准仓库——不能每个部门一个标准 管 元数据/标准/质量/安全管理 建质检体系——进来的货得合格 用 资产目录+服务门户+AI智能用数 让产品产生收益——货要能卖出去 这个类比不是比喻,而是规律。任何企业想靠数据产生收益,五个动作一个都不能少。 但这里有一个关键洞察:"管"是最容易卡住的一步。 前两步性质不同:理是认知活——搞清楚目标是什么、自己有什么、标准是什么、谁对数据负责;采才是技术活——编脚本、跑任务、拉数据,大部分技术团队能搞定。第三步(存)是设计活——建模型、分层级、定规范,有经验的架构师做得到。 第四步"管"的性质完全不同。元数据谁来维护?质量标准谁来定?数据问题谁负责修?这些不是技术问题,是组织问题。大量的中台项目正是因为"管"这一步没走实——规则配了但没人处理告警,质量报告出了但没人推动修复——"用"就变成了空中楼阁。业务部门嘴上不说,心里不信这个数,自然不敢拿来决策。 而资产化的前提,恰恰是"管"到位。没有可信的数据,资产化只是账面游戏。 四、方法论拆解:理→采→存→管→用,五步走通资产化 4.1 理:摸清家底,定义"什么是资产" 核心动作:梳理全量业务对象 → 盘点数据资源 → 形成数据资产清单。 数据资产化的第一步,不是定标准,不是建平台,而是搞清楚自己有什么。很多企业在"理"这一步就栽了跟头——跳过盘点直接做采集,数据接进来才发现编码不统一、口径不一致、同一类数据在三个系统里各有各的叫法。 关键原则:先弄清楚有什么,不要一上来就定标准。 常见误区:把"理"理解成"写文档"。资产盘点的产出不是一份Excel清单,而是可被系统识别和管理的结构化资产目录——有了它,后面的采、存、管、用才有靶子。 与资产化的关系:资产盘点是入表的前置条件。不知道有什么数据,就无法评估它们的价值;没有资产清单,入表就没有依据。理清家底是资产化的第一块基石。 4.2 采:汇聚数据,打通"资产供应链" 核心动作:多源异构数据归集 → 流批一体集成 → 增量同步。 资产盘清楚了,接下来要把散落在各处的数据"收"到统一平台。这一步的技术难点不在"能不能接",而在"接得好不好"——是每天凌晨跑一次全量,还是秒级增量同步;是只接结构化表,还是日志、IoT流数据全收。 关键原则:先聚焦高价值域,不全量铺开。选1-2个核心业务域先走通,有了成果再横向扩展。 常见误区:采集范围过大。目标是"全覆盖",结果项目周期拉长到半年——领导失去耐心,团队失去动力。 与资产化的关系:数据不到一处,资产就无法形成统一视图。采集汇聚是资产化的物理基础——没有这一步,所有关于资产化管理的讨论都是纸上谈兵。 4.3 存:标准建模,为"资产"建立统一量纲 核心动作:数据模型规划 → ODS-DW-ADS分层 → 标准化存储。 数据汇聚之后需要一个"标准仓库"——不是把原始数据原样堆进去,而是按照统一的模型和规范重新组织。这一步的价值在于:让不同来源的数据在同一个语义体系下被理解和使用。 关键原则:模型要在系统里跑,不能只在文档里。数据模型设计得再漂亮,如果只在 Visio 和 Word 里存在,就失去了意义——必须和元数据管理打通,让模型在平台中"活"起来,自动约束数据接入时的格式和语义。 常见误区:模型设计脱离业务语义。技术表名(如ods_pay_txn_f)业务人员看不懂,建模成了技术自嗨。好的数据模型应当让业务和技术都能"对得上号"。 与资产化的关系:统一的数据模型是资产可计量的基础。如果不同系统里同一类实体的编码方式都不一样,资产口径就对不齐;口径对不齐,资产估值就无从谈起。 4.4 管:治理闭环,让"资产"变得可信 ⭐本章核心 核心动作:四维治理 —— 元数据管理 + 数据标准落标 + 数据质量闭环 + 数据安全管控。 一、元数据管理:形成全企业数据地图。 通过自动采集技术元数据(表结构、字段类型、数据量)和手动补全业务元数据(业务含义、责任人、更新频率),建立企业内部的数据"黄页"。血缘解析进一步展示数据从哪来、经过了哪些加工、最终去了哪里——让数据流转不再靠"问小李"。 二、数据标准落标:让"同一个东西有同一个名字"。 在元数据管理模块中统一定义字段命名、编码规则、值域范围,数据接入时自动校验合规性,不合规的退回源系统修正。标准不是贴在墙上的标语,是嵌在流程里的规则。 三、数据质量闭环:从事后救火到持续监控。 这是"管"阶段技术含量最高、也最容易半途而废的一环。推荐采用旁路监测模式——数据正常入库,质检规则并行扫描,发现问题打标记、发告警、自动生成工单,推动责任人修复。不拦截、不阻断业务流转,治理和生产并行不悖。龙石数据中台即采用这一旁路监测质量管控模式,在不侵入业务系统的前提下完成质量闭环——质检并行扫描数据流,发现异常自动打标告警、生成工单驱动修复。 四、组织机制:让治理从"项目"变成"习惯"。 以上三步再好的技术手段,如果没有配套的组织机制都会退化。需要成立数据管理部或数据治理委员会,设立数据管家岗位,将数据质量指标纳入业务部门绩效考核——数据治理首先是组织治理,其次才是技术治理。 常见误区:规则配上了但没人看告警——治理停在"发现"不走到"修复",质量报告成了一月一出的例行公事。 与资产化的关系:"管"是资产化的绝对前提。质量不可信的数据不能估值——估值的前提是数据准确、完整、一致。标准不统一的数据资产边界不清——同一实体多个口径,资产范围就没法定。没有安控体系的数据不能流通——入表只是第一步,后续的共享、交易、融资都要求安全合规。 4.5 用:服务化输出,让"资产"创造价值 核心动作:资产目录编目 → API服务化 → 数据超市 → AI智能用数。 理、采、存、管四步走完,数据已经从散落的原始资源变成了可信可管的数据资产。最后一步要让这些资产被"用起来"——资产不流动,价值就只停留在纸面上。 第一步,建资产目录。 基于治理成果,将数据资产按业务域编目发布,让业务人员用业务语言就能找到自己想要的数据。目录不是技术文档,是面向业务的数据"产品手册"——能告诉业务人员"你有什么、能用在哪、质量怎么样"。 第二步,API服务化。 数据资产不能只"看得见",还要"拿得到"。将高频数据需求封装为标准API,让业务系统通过接口直接调用,不用每次都找IT写SQL。 第三步,降低用数门槛。 这是从"资产化"走向"价值化"的关键一跳。龙石AI用数智能体支持业务人员用自然语言提问——"本月充电量最高的前十个站点是哪些"——直接返回分析结果,让不会写SQL的人也能自助用数。 常见误区:资产化了但不让人用——目录建完没人访问,API发布没人调用。资产化的终点不是入表,入表只是对资产状态的确认;真正的终点是数据被持续使用并创造业务价值。 五、实践映射:三阶段走通全路径 5.1 落地路线图 "理采存管用"五步路径不应理解为串行接力,实践中是螺旋迭代的过程。推荐三阶段落地: 阶段 时间 核心动作 产出 第一阶段:以"理"为起点 4-6周 盘点数据资产、构建核心标准、设定质量基线 数据资产清单 + 核心主数据标准 + 质量基线报告 第二阶段:采存管用跑闭环 6-8周 选1-2个高价值域,完整跑通全链路 可运行的治理流程 + 已验证的数据应用场景 第三阶段:用治协同扩体系 持续 横向扩展业务域 + 纵向深化标准和质量 企业级数据资产体系 + 常态化运营能力 第一阶段的关键产出是三份文件:资产清单说清楚"有什么",核心标准说清楚"长什么样",质量基线说清楚"目前什么水平"。三份文件做完,企业就有了资产化的"起跑线"。 第二阶段是"打样"——选一两个最有价值的业务域,把五步全链路跑通。这个阶段的目的是快速做出可见的业务成果,用事实说服更多业务域参与进来。 第三阶段是"扩面"——横向覆盖更多业务域,纵向拉高标准和质量的执行水平。这一阶段的关键是建立常态化运营机制,防止"做完项目团队解散、治理退回原点"。 龙石数据中台按理采存管用方法论进行模块化设计,各模块既可独立部署也能协同工作——资产盘点模块对应"理",数据集成模块对应"采",数据仓库对应"存",元数据/标准/质量/安全管理模块对应"管",资产目录、API网关和AI用数智能体对应"用",使方法论从概念框架转化为产品落地。 5.2 DCMM九域与理采存管用的落地映射 DCMM 2.0能力域 理采存管用阶段 中台落地动作 数据战略 → 数据治理 理 梳理业务流程、盘点数据资源、建立治理组织 数据架构 → 数据生存周期 采 多源数据汇聚、流批一体增量归集 数据架构 → 数据标准 存 数据模型设计、数仓分层存储 数据治理/标准/质量/安全 管 元数据管理、标准落标、质量闭环 数据应用流通、数据资产 用 资产目录编目、API共享、AI智能用数 DCMM 2.0新增的"数据资产"域横跨"理"和"用"两端——"理"阶段完成资产盘点,"用"阶段实现资产价值释放。这意味着"数据资产"不是一个孤立的考核项,而是贯穿全过程的结果——理采存管用五步走扎实了,资产化自然水到渠成。 六、案例验证:从治理到资产化的真实路径 6.1 福建某交投集团:数据资产入表之路 福建某交投集团是龙石数据服务的一家国企,也是"理采存管用"走通资产化全路径的典型案例。 起点:家底不清。 项目启动时,充电系统、调度系统、安防系统等各个业务系统里散落着上千张业务表。表面上看数据不少,但一深挖就发现问题——同一类充电桩数据分散在三个系统中,各有各的命名规则。仅资产目录梳理就涉及上千张表,光是把"谁有什么数据"这件事搞清楚,就花了数周时间。 路径:三步走通。 第一步(理),全量数据资产盘点——不谈标准、不谈质量,先把家底摸清楚。第二步(管),建立数据标准体系,统一跨系统的命名规则、编码规范和质量校验标准。在此之前,同一类数据在三个系统有三种说法——标准体系建设让数据语言首次统一。第三步(用),基于治理后的数据目录,完成资产质量评估和合规审查。依托《GB/T 36344-2018 信息技术 数据质量评价指标》为框架,质量评价总评分达99.53分。 结果:成功入表。 首批数据资产成功入表,成为福建省某市国企中第一批完成数据资产入表的企业。集团第一次真正搞清楚了自己有多少数据、哪些数据有价值、哪些需要治理。 核心论断:数据资产入表不是会计问题,是数据治理问题。表能不能入,取决于有没有做资产盘点(理)、有没有建立标准体系(管)、有没有做质量评估(管)。理采存管用的每一步都在这个案例中得到了验证。 6.2 上海某化工企业:治理驱动型建设 上海某大型化工企业的数据中台建设提供了另一个视角——"管"的价值不仅体现在资产化上,更体现在业务效率的直接提升上。 做法:该企业采取"咨询先行、治用并举"的策略。先统一了物料编码标准,再建立质量校验规则,最后才搭建中台平台——治理不是平台上线以后才做的事,而是贯穿全过程的默认配置。效果非常显著:库存周转率提升28%,订单交付及时率提升至91%,报表生成周期提前4天。 更关键的是,该企业成立了数据管理部,将数据治理从"项目驱动"转变为"机制驱动"——治理能力内化为组织的日常运营,而不是依赖于某一期项目的生命周期。 启示:治理与平台建设不是先后关系,而是并行关系。标准和质量不应该等平台建好了再补,而应该在数据接入的那一刻就嵌入流程。 七、常见问题 Q1:做了数据治理就一定能实现数据资产化吗? 不一定。治理解决的是"数据是否可信"的问题,资产化还需要完成资产确认、合规审查和价值评估。治理是必要条件,但不是充分条件。但反过来,没有治理,资产化一定走不通——质量不可信的数据无法估值,标准不统一的数据边界不清。DCMM 2.0新增"数据资产"域,就是在标准层面确立了"治理→资产化"的递进关系。 Q2:企业应该先做治理还是先做资产盘点? 先盘点。不知道有什么数据就去谈治理标准,容易搞出一堆没人用的规范。用"理"先摸清家底,再挑选高价值数据资产优先治理。这和福建交投的路径一致——先花数周盘点上千张表,再建标准体系。 Q3:理采存管用五步必须按顺序走吗? 框架上建议按顺序,但实践中是螺旋迭代。"理"先定基线,"采存管用"在小范围内并行跑通,"用"过程中发现的问题反馈到"管"和"理"持续优化。不是串行接力,而是相互驱动的闭环。第一阶段先花4-6周完成资产盘点和质量基线,第二阶段选核心域跑通全链路,第三阶段持续迭代。 Q4:中小企业资源有限,怎么落地这套路径? 不需要像大型国企那样全量铺开。选最核心的1-2个业务域,花4周做资产盘点和质量基线,再花6周搭建轻量平台跑闭环。一个域跑通了,就有了模板和说服力。龙石数据质量管理平台社区版免费可用,覆盖数据质量评价的主要维度——中小企业可先做一次数据质量体检,再根据结果决定下一步投入。 八、结语 数据治理是手段,数据资产化是目标。"理采存管用"提供的不是理论框架,而是一条经过验证的工程路径——理清家底、汇聚供应链、建立标准仓库、构建质检体系、实现资产价值。路径的核心在"管"——只有管到位的数据,才配叫"资产"。 DCMM 2.0新增"数据资产"能力域不是偶然。这是整个行业从"过程导向"转向"结果导向"的标志——数据管理能力不再只看你做没做、做了多少,而是看你做出了什么:有没有可信的数据资产、能不能持续运营、是否创造了可衡量的业务价值。 给CDO的行动建议:不要等完美方案。找一两个核心业务域,先用"理"摸家底,用"管"建基线,再以"用"的价值说服老板和业务部门。一个域跑通全链路,比一百页规划PPT更有说服力。 给治理经理的行动建议:找到一个高价值业务域,完整跑通"理→采→存→管→用"全链路。用业务结果说话——库存周转提升了、交付及时率提高了、资产入表成功了——治理的价值自然会被看见。 工业时代,企业竞争的是设备和资金。数字时代,企业竞争的是数据资产的运营能力。谁能率先建立"资源化→资产化→价值化"的闭环,谁就更有机会把数据真正转化为生产力。理采存管用不只是方法论——它是从数据资源到数据资产的施工图。

"我们选了一家厂商,演示很漂亮,功能列表拉出来两百多项。但上线半年后,业务部门还是用不起来。" 这是一家制造企业CDO的经验之谈——过去一年里,类似的情况在不同场合反复上演。他们的团队花了七个月选型、三个月部署,最终发现:功能都有,但业务不买账。标准没落地——同一物料在三个系统里三种编码;质量没闭环——数据对不上,排查一次要追溯到四五个源系统;元数据缺失——业务人员想查一个字段的来源,得翻ETL脚本。平台跑通了,数据管理能力没跟上。 选型踩坑,不缺教训。缺的是一套能落地的评估框架。 2025年的特殊背景让这个问题更加紧迫。三股力量正在叠加:政策端,财政部《企业数据资源相关会计处理暂行规定》(财会〔2023〕11号)已施行两年,数据资产入表从试点走向扩面——当数据要上资产负债表,治理就不再是可选项;标准端,DCMM 2.0(GB/T 36073-2025)将于2026年7月1日正式实施,能力域从8个扩展为9个,新增"数据资产"能力域,对企业数据管理能力的要求系统性升级;技术端,Data-Centric AI的研究反复验证了一个朴素逻辑——AI效果的上限取决于数据质量,而不是模型参数,企业AI项目的"数据就绪"正在从"最好有"变成"必须有"。 在这三股力量的共同作用下,2025年选一个数据治理平台,已经不是选一个IT工具的问题——是在选未来三到五年的数据管理基础设施。 本文提供一套可操作的评估框架,说明各维度在实际产品中如何落地。你可以把它当作一份选型检查清单:先建立标准,再对照验证。目标是帮你建立自己的判断力,而不是帮你选产品。 二、选型前的自我审视:先问对问题 在讨论厂商之前,有三个问题需要先回答。它们决定了你的选型侧重点——对有些企业来说,数据集成能力是第一优先级;对另一些企业来说,数据治理深度才是决定成败的关键。 问题一:你建数据治理平台要解决什么核心问题? 是数据孤岛打通——多个系统之间的数据口径不统一、无法关联分析?是数据质量太差——业务部门的报表定期"对不上",每次排查都要耗费大量人力?还是缺少统一的数据服务层——数据有,但每个业务部门要数据都得走IT排期? 不同行业的核心痛点差异很大。制造业的痛点在物料编码和BOM数据的一致性;金融行业的痛点在监管报送的数据准确性和时效性;集团型企业的痛点在多组织之间的数据共享和标准统一。先定位自己的核心问题,才能在评估时不被厂商的功能列表带偏。 问题二:你的团队能力和治理现状如何? 有没有专职的数据治理团队?团队成员具备什么样的能力结构?DCMM"数据治理"能力域明确指出,数据治理首先是组织治理,其次才是技术治理。如果企业连一个对数据标准和质量负责的岗位都没有,那么选型时就需要格外关注厂商的培训和陪跑能力——平台建好之后有没有人用、会不会用,比平台本身的功能列表重要得多。 建议在选型前做一次简单的自评:对标DCMM五个成熟度等级,你的组织现在处于哪个层级?是数据分散、手工出报表的初始级,还是数据已经集中但治理尚未形成闭环的受管理级?这个定位会直接影响你选型时的功能优先级。 问题三:你的IT环境复杂度和管理诉求? 涉及多少套业务系统?有没有信创要求?组织形态是单体企业、集团多组织,还是多级行政体系?这些因素直接决定了平台架构的选型门槛。 一个典型的教训来自某省级城投集团——下辖12家子公司,业务涵盖地产、水务、交通。他们在选型时确定了一个硬性标准:厂商的工作空间模型必须能支撑"总部统一标准管控、子公司独立自治"。经过POC验证,他们淘汰了三家只能做单体部署的厂商。如果你的企业有类似的多组织管理诉求,架构的扩展性就不是加分项,而是一票否决项。 DCMM"数据战略"能力域提出,组织应首先明确数据管理的目标和优先级。选型前的自我审视,就是在完成这一步。三个问题没有标准答案,但它们帮你定义了属于你自己的评估权重。 三、评估框架总览:五维选型模型 基于DCMM 2.0九大能力域和DAMA-DMBOK2数据管理框架,结合企业在实际选型中的高频痛点,我们提炼出一个五维评估模型。它不追求面面俱到,而是聚焦数据治理平台选型中最关键的五个决策维度。 评估维度 核心问题 治理能力完整度 平台能否让数据"好管好用"?数据标准、数据质量、元数据管理是否形成闭环? 平台架构开放性 能否与现有IT生态兼容?能否支撑组织从单体到集团的扩展? 智能自动化水平 AI和自动化在多大程度上降低了数据治理和用数的门槛? 安全防护机制 数据全生命周期安全是否有保障?信创适配和合规是否到位? 长期业务价值 厂商是交付完就走,还是帮你建立持续的数据管理能力? 这五个维度不是打分表——它不鼓励你给每个维度打一个分数然后算总分。它的作用是帮你建立一个系统性的评估视角:在考察任何一款产品时,不是只盯着某一个维度(比如功能数量),而是同时看到五个维度,再根据自己的实际情况分配权重。选型不是选"最好的",是选"最适合你的"。 下面逐一展开这五个维度——每个维度都包括"评估什么、问什么、怎么看"三个层次。 四、维度一:数据治理能力完整度 4.1 为什么治理能力是选型第一维度 DCMM 2.0将数据标准、数据质量、数据架构列为核心执行域。这三个域不是锦上添花的"治理装饰",而是决定一个平台到底是"数据仓库"还是"数据底座"的分水岭。数据仓库只管存,数据底座要管能力——标准有没有落地执行、质量有没有持续监控、元数据能不能支撑业务人员自助找数,这些决定了数据的可发现性、可信度和可用性。 截至2024年7月,全国累计3298家次完成DCMM贯标评估。大量评估实践揭示了一个规律:建了数据中台但DCMM评级上不去的企业,失分最多的往往就是标准、质量、元数据和架构这四个能力域。平台跑通了,能力没跟上——这是最常见的问题。选型时第一个要看的,就是治理能力有没有"产品化"。 4.2 数据标准:从文档到执行 DCMM不仅要求"制定标准",更要求"执行标准"。很多企业有厚厚的数据标准文档,但标准停留在纸面上——字段命名规范是有了,数据接入时没人校验;编码规则是定了,新系统上线时还是各起各的。 选型时要追问三个问题:第一,平台能不能定义字段级的业务标准和校验规则,而不只是元数据描述?第二,这些标准能不能在数据接入时自动执行落标校验,不合规的直接退回源系统?第三,标准和校验规则能不能由业务人员和IT人员共同维护,而不是纯技术配置? 一个可参照的标杆:部分产品如龙石数据中台基于"理采存管用"方法论,在多个项目中通过标准自动落标,将字段合规率从60%提升到95%以上。关键不在于"有标准管理",而在于标准定义之后能不能自动作用于采集链路——这才是从文档到执行的跨越。 4.3 数据质量:从事后救火到持续监控 DCMM数据质量域涵盖质量需求、检查、分析和提升四个过程域。传统模式是"事后救火"——业务部门发现数据不对、提工单、IT排查、修复。这种模式的代价不在修复本身,而在排查——一次"数据不准"的反馈,可能涉及三四个源系统的日志回溯、十几张表的数据比对、多部门联合对账。 选型时看三个能力:质量规则能不能可视化配置,让业务人员也能参与而不仅是依赖IT?能不能做到旁路监测——并行扫描数据但不阻断业务系统的正常运行,发现问题打标记或触发告警工单?能不能从问题数据追溯到源头系统和责任人? 江西某国控集团在这一维度上的实践提供了一个参考坐标:他们通过建立数据质量闭环管理机制,将核心数据质量问题的修复周期从两周缩短到两天。这不是靠增加人手实现的——是把"人工排查"变成了"规则自动扫描+自动定位"。数据质量是数据共享的第一前提:如果数据不可信,再多的共享通道也无人敢用。 4.4 元数据与资产目录:让数据可发现、可理解 当数据出现问题,治理团队需要回答几个基本问题:这个字段来源是哪个系统?经过哪些加工步骤?最近一次变更是什么时候?在没有自动化元数据采集和血缘追踪的情况下,回答这些问题的方式往往是翻阅ETL脚本、查找工单记录、询问相关开发人员——熟悉历史代码的人一旦离开,追溯难度还会进一步上升。 选型时问三个问题:元数据采集是全自动还是大量依赖手工录入?血缘分析能不能跨系统追踪——从源系统字段一路追到BI报表的指标?资产目录是IT人员的"技术台账",还是业务人员能用业务语言检索、理解和申请使用的"数据地图"? 学术研究(arXiv:2402.05211)给出了一个清晰结论:好的数据目录不只是技术工具,更是促进跨团队数据共享和复用的组织基础设施。在选型时,资产目录的业务友好度——能不能让非技术人员自助找数——是一个常被低估但实际影响深远的指标。 4.5 治理能力评估小结 子维度 核心检查项 数据标准 字段级标准定义 → 自动落标校验 → 不合规退回 数据质量 可视化配置规则 → 旁路并行监测 → 问题溯源到源头 元数据管理 全自动采集 → 跨系统血缘追踪 → 字段级追溯 资产目录 业务语言检索 → 自助申请 → 质量评分可见 产品对照:部分产品如龙石数据中台基于"理采存管用"方法论,将数据标准管理、质量监测、元数据与血缘、资产目录设计为可独立运行的治理模块,企业可按需选择切入点,先在最痛的数据域建立闭环再逐步扩展。 五、维度二:平台架构开放性 5.1 兼容集成:不是选一个产品,是选一个技术伙伴 数据治理平台不是孤立运行的——它需要和你已有的ERP、MES、CRM、OA等系统协同工作。选型时如果不考察架构开放性,相当于买了一台发动机但没有考虑它能不能装进你的车。 三个层面的兼容性需要逐一验证。数据库层面:支持哪些数据库?信创环境适配了吗?——达梦、人大金仓、海量数据、OceanBase等国产数据库是否在兼容列表中?集成方式层面:多源异构数据接入是通过标准接口(JDBC/API/消息队列)还是私有协议?能不能对接已有的数据集成工具?部署模式层面:是否支持纯私有化部署?能否适配混合云场景? 中国信通院《数据治理产业图谱3.0》指出,头部厂商正从"单一产品"向"平台化、组件化、可组装"方向演进。这个趋势对选型者的启示很直接:你选的不是一个功能完备的"黑盒",而是一组可与你现有技术栈组合的能力模块。 5.2 扩展性:从部门级到集团级 很多数据治理平台在部门级场景下表现良好,但一旦扩展到集团多组织场景,架构瓶颈就暴露了。今天是三个业务系统接入,明年可能是十个。今天是单体企业用一个实例,后年可能是集团管控需要分权分域。 选型时的核心检查项是工作空间模型:平台能不能做到"总部统一标准管控、子公司/部门独立自治"?具体来说——总部能不能定义全集团的数据标准和核心质量规则?各子公司能不能在自己的工作空间内独立管理数据资产目录、配置业务级规则?能不能实现跨空间的数据共享和权限隔离? 江苏某建筑装饰集团(下辖200+家子公司)的实践提供了一个参照:通过多租户架构实现跨公司数据协同后,月底对账时间从5天缩短到1天,数据纠纷减少约80%。某省级城投集团的POC则验证了另一个结论:他们在选型中淘汰了三家只能做单体部署的厂商——不是因为这些厂商的功能不够,而是架构模型无法支撑"集团管控+子公司自治"的双重诉求。 5.3 架构评估小结 评估项 核心检查点 数据库兼容 主流数据库+信创数据库适配认证 集成方式 标准接口(非私有协议)、流批一体 部署模式 私有化部署、混合云支持 工作空间 多租户模型、分权分域、跨空间协同 产品对照:部分产品如龙石数据中台采用"一集团一中台、一公司一空间"的工作空间模型,支持总部统一标准管控与子公司独立自治,已在多个集团型企业中验证了从部门级到集团级的扩展路径。 六、维度三:智能自动化水平 6.1 质量管控的自动化:从手写SQL到可视化配置 传统的数据质量管理大量依赖手工——ETL脚本里写死校验规则,出了问题手动排查,质量报告靠人工统计。这种方式在数据量小、系统少的时候勉强可行,一旦数据源超过10个、数据表超过500张,手工模式就彻底不可持续。 2025年的数据治理平台,自动化水平应该成为硬性评估指标。核心看两点:质量规则的配置门槛和监测的执行方式。 在配置门槛上,选型时要问:质量规则能不能通过可视化界面配置,而不需要写SQL或代码?业务人员能不能参与规则的定义——比如业务部门自己设定"订单金额不能为负""客户名称不能为空"这样的业务规则?如果质量规则只能由IT人员配置,那平台本质上还是技术工具,不是治理平台。 在监测方式上,关键是"旁路监测"能力——质量扫描在数据流转过程中并行执行,不侵入业务系统、不阻断数据流转,发现问题打标记、发告警、生成工单,而不是等到业务投诉再排查。 6.2 AI用数:降低数据使用门槛 大多数企业的数据使用现状是:只有会写SQL的人才能做数据分析,业务部门的用数需求高度依赖IT排期。AI用数能力的出现正在改变这个局面——自然语言查询、智能问答、AI辅助分析,让不会写代码的人也能与数据交互。 选型时看三个层次:第一,平台有没有资产目录作为AI用数的"知识底座"——AI需要知道有哪些数据、数据在哪、数据是什么意思,没有元数据层,AI读不懂数据。第二,自然语言查询的准确率怎么样——能不能在真实业务场景中稳定输出?第三,AI用数能不能做到数据不出域——私有化部署的大模型或检索增强生成(RAG)方案,确保数据安全。 江苏某国企数科的实践具有参考价值。他们运营的数据要素流通平台在部署AI用数智能体后,用户可以通过自然语言完成数据资源的查询和流程引导。更深层的变化在运营机制层面——运营团队从"凭感觉安排数据产品上架"转变为"依据智能体的需求报告召开数据产品决策会",咨询工单量显著下降。 Data-Centric AI的核心主张在此处尤为重要:AI效果的上限取决于数据质量,而不是模型参数。在数据治理上投入的每一分精力,最终都会在AI效果上体现出来。 6.3 自动化评估小结 评估项 核心检查点 质量规则配置 可视化、业务人员可参与、不需要写SQL 质量监测方式 旁路监测、不阻断业务、自动告警 AI用数 自然语言查询、资产目录驱动、数据不出域 产品对照:部分产品如龙石数据中台内置旁路监测质量管控和AI用数智能体,支持可视化配置质量规则和自然语言分析数据,将治理和用数的自动化贯穿于"管"和"用"两个环节。 七、维度四:安全防护机制 7.1 安全合规已从"加分项"变为"一票否决项" 2021年9月1日起施行的《中华人民共和国数据安全法》,确立了数据分类分级保护制度,要求企业建立全流程数据安全管理制度。在这个法律框架下,数据安全合规已不是"做得好加分",而是"做不到出局"。 选型时安全维度的评估不需要深入到加密算法或攻防体系的细节——这些是安全产品的评估范畴。对于数据治理平台而言,聚焦三个可验证的合规指标: 第一,是否支持完全的私有化部署——数据不出域,是数据安全合规的底线。第二,是否具备数据分类分级能力——能否按照企业的安全策略对数据进行分级标记、按级管控?第三,脱敏能力如何——在数据共享和对外服务时,能否自动执行脱敏规则? 这些能力不需要在POC中做安全攻防测试,但需要在产品演示中看到:分类分级的配置流程、脱敏规则的实际效果、权限管控的粒度。 7.2 信创适配不是"认证列表有多长" 信创环境适配是2025年选型中绕不开的话题。但需要提醒的是:认证列表长,不代表适配好。 选型时的正确做法是:第一,确认厂商有完整的信创适配认证——操作系统(麒麟、统信)、数据库(达梦、人大金仓、OceanBase)、芯片(鲲鹏、飞腾)等主流信创产品是否在列。第二,也是最关键的一步——在POC阶段,就在你的实际信创环境上跑一遍。产品在认证实验室里"能跑"和在你的生产环境中"跑得稳"是两回事。 产品对照:部分产品如龙石数据中台已完成麒麟、统信、达梦、人大金仓、OceanBase、华为等主流信创产品的兼容性认证,全系产品只做私有化部署,数据不出域。 八、维度五:长期业务价值 8.1 交付≠完成:看厂商的持续服务能力 数据治理平台不是买个软件装上就完了。它涉及组织变革、流程重构和团队能力建设,是一个持续运营的过程。很多厂商签完合同、部署上线后就转为被动支持模式——有问题你找我,没问题我就等着。但治理平台真正的价值在持续运营中释放。 选型时追问三个问题:部署完成后,厂商会参与运营吗,还是只做远程支持?有没有成熟的培训+陪跑机制——不是一两次集中培训,而是涵盖"为什么做→怎么做→动手做"的梯度赋能?厂商有没有同行业的持续运营案例——不是"做过多少项目",而是"哪个客户在项目结束一到两年后还在自主运营"? DCMM在多个能力域中强调,数据管理能力的提升需要组织文化、人员技能和流程机制的综合配套——仅靠工具无法实现成熟度的跃升。DAMA-DMBOK2同样指出,数据管理的成功依赖于"人员、流程和技术的协同",技术只是三个支柱之一。这给选型者一个明确的信号:选产品,更要选服务能力。 新疆某热力公司的案例提供了一个参照。这家企业承担全市集中供热业务,SCADA、收费、GIS等系统各自独立运行,数据标准不统一,基层人员经常重复录入数据。在建设数据中台的过程中,实施团队没有把工作停留在平台交付层面——围绕理论、实施、实战三个阶段,通过系统化培训帮助信息部门建立对DCMM、DAMA以及方法论的整体认知;结合实际业务场景,指导团队配置数据标准和质量规则;并以真实业务问题为切入点,带领客户完整走通数据治理实践。项目完成后,企业组建起自己的数据管理团队,并将相关机制持续运营至今。 8.2 数据资产化:平台能否支撑长期价值释放 2025年选型,不能只看当下的功能需求,还要看平台能不能支撑未来三到五年的价值演进。这个演进的核心方向是数据资产化——从把数据管好,到把数据变成可计量、可评估、可变现的资产。 选型时看三个能力台阶。第一台阶——资产目录:平台有没有支持业务人员检索和申请的数据资产目录?这不是一个简单的"数据列表",而是数据的"卡片索引"——包含数据来源、质量评分、更新频率、使用权限等关键信息。第二台阶——DCMM贯标支撑:平台的能力是否能和DCMM 2.0的评估域形成映射?当企业准备申报DCMM贯标评估时,平台能不能提供证据材料——标准执行记录、质量监测报告、元数据资产清单?第三台阶——数据资产入表基础:平台能不能为数据的成本归集、使用量统计、价值评估提供基础数据?当财政部财会〔2023〕11号推动数据资产入表从试点走向扩面,这个能力将从"锦上添花"变成"刚性需求"。 上海某大型化工企业的实践展示了这个演进路径的可能性。他们在数据中台建设过程中,先统一了物料编码等核心数据标准,建立了数据质量规则和管理流程。效果在业务层面直接体现——库存周转率提升28%,订单交付及时率提升至91%。更深远的变化在组织层面:企业成立了数据管理部,实现了从"项目驱动"到"机制驱动"的转变。 8.3 长期价值评估小结 评估项 核心检查点 持续服务能力 培训+陪跑机制、同行业持续运营案例 资产目录 业务友好、质量评分可见、支持自助申请 DCMM贯标支撑 能力域映射、证据材料产出 资产化支撑 成本归集、使用统计、价值评估基础 产品对照:部分产品如龙石数据提供"培训+陪跑"全周期赋能体系——三层培训(理论→实施→实战)和三步陪跑(培训→样板工程→远程支撑),帮助企业实现从"供应商驱动"到"自主运营"的转变。 九、产品映射:五个维度如何落地到产品 五个维度的评估框架回答了"看什么"的问题,接下来需要回答"怎么看"——这些维度在具体的产品中如何体现?DCMM 2.0定目标、"理采存管用"方法论定路径、产品模块定落地,三者之间的关系可以用一张表来呈现。 评估维度 对应DCMM能力域 对应方法论环节 产品能力关键检查项 治理能力完整度 数据标准/质量/架构 理→管 标准自动落标、质量旁路监测、元数据自动采集与血缘 平台架构开放性 数据架构/生存周期 采→存 多源异构接入、多租户工作空间、标准接口(非私有协议) 智能自动化水平 数据应用/流通 管→用 可视化配置质量规则、自然语言用数、AI辅助分析 安全防护机制 数据安全 管 私有化部署、信创适配、分类分级与脱敏 长期业务价值 数据战略/治理/资产 理→用闭环 培训陪跑体系、DCMM贯标支撑、资产化路径 这张映射表的价值在于:当你对一个产品进行五维评估时,每个维度都对应着可验证的产品能力——不是凭感觉打分,而是逐项检查。 更深一层的含义是:五个维度不是独立的功能清单,而是一个问题的五个面。选型时问"这个维度怎么落地",本质上是在问"方法论有没有产品化"。DCMM 2.0告诉你"要管什么",方法论告诉你"怎么管",产品模块告诉你"谁来执行"。选型时如果发现三者之间存在断层——标准写得好但产品落不了、架构设计得漂亮但POC跑不动——那就是需要高度警惕的信号。 十、选型清单与行动建议 10.1 五维评估速查表 把前面五个维度的评估要点浓缩成一张速查表。在选型的每个阶段——需求梳理、厂商初筛、POC验证、最终决策——都可以用它做快速对照。 评估维度 核心问题 怎么验证 治理能力完整度 数据标准/质量/元数据是否形成闭环? 拿真实业务场景让厂商现场配置一条全流程(建规则→跑监测→出报告→问题追溯) 平台架构开放性 能不能和你现有系统无缝对接? 查信创兼容性认证、在POC环境实测多源接入 智能自动化水平 自动化降低了多少治理和用数门槛? 让业务人员(不是IT人员)现场操作质量规则配置和自然语言查询 安全防护机制 安全合规是否到位? 确认私有化部署能力、数据分类分级和脱敏的配置流程 长期业务价值 厂商是交付完就走还是持续赋能? 要求厂商提供一个项目结束一年后客户仍在自主运营的真实案例 10.2 给决策者的行动建议 第一步:先理清家底。 在接触任何厂商之前,用DCMM框架做一次自评——你现在处于哪个成熟度等级?最痛的数据域是哪个?是物料编码不统一,还是客户信息混乱,还是报表口径不一致?这份自评报告既是选型需求的输入,也是后续POC验证的基线。如果你的团队对DCMM不熟悉,可以先对标DAMA-DMBOK2的核心领域做一个简化版的数据管理现状梳理。 第二步:POC聚焦核心域。 POC最常见的错误是"全功能演示"——让厂商把系统里所有功能都跑一遍。结果看起来什么都好,但什么都验证不深。正确的做法是:选一个最痛的数据域,用一个真实的业务场景,验证从标准定义、数据接入、质量监测、问题追溯到资产发布的完整闭环。一个域跑通了,评估框架就立住了;所有功能都看了个大概,等于什么都没验证。 第三步:问对问题。 不问"你们有哪些功能",问"这个功能在实际项目中怎么落地的"。不问"做过多少项目",问"能不能讲一个项目从启动到验收再到持续运营的全过程"。不问"认证列表有多长",问"能不能在我们的实际环境上跑一遍"。问题的质地,决定了你能获取的信息的质地。 十一、常见问题 FAQ Q1:功能多少算够? 不是越多越好。数据治理平台的核心价值在治理深度,不在功能广度。如果你的核心需求是数据集成和共享,可以先上集成+质量模块,跑通之后再扩展。如果你建的是长期数据底座——数据标准、数据质量、元数据管理、资产目录这四个模块一个都不能少,这也是DCMM 2.0重点评估的核心能力域。判断标准不是"有多少功能",而是"核心域能不能形成闭环"。 Q2:中小团队预算有限怎么选? 不要看总价,看首年投入和见效速度。选模块化产品,先上最紧迫的模块跑通闭环,再逐步扩展。单台16C32G起步、部署周期约一周的轻量化方案,适合不想一次性大投入的企业。关键不是"买了多少模块",而是"第一个模块能不能在一个月内让业务部门看到变化"。 Q3:治理平台和AI项目应该先做哪个? 先治理后AI。Data-Centric AI的研究反复验证:在数据治理上投入的每一分精力,最终都会在AI效果上体现出来。不需要"完美治理",但至少做到"最小可用治理"——AI需要知道有哪些数据、数据在哪、数据是什么意思。在一个"客户名称"在三个系统里三种写法的数据环境里,再好的AI模型也给不出可靠的分析结论。 Q4:信创环境怎么评估? 确认厂商有完整的信创适配认证,且在POC阶段就在实际信创环境上实测。认证列表是必要条件,但不是充分条件——实验室里"能跑"和生产环境中"跑得稳"是两回事。建议把信创环境测试纳入POC的硬性环节,而不是作为可选项。 参考来源 [1] GB/T 36073-2025《数据管理能力成熟度评估模型》(DCMM 2.0),九大能力域,2026年7月1日起实施 [2] DAMA International, DAMA-DMBOK2: Data Management Body of Knowledge, 2nd Edition [3] 《中华人民共和国数据安全法》,2021年9月1日施行 [4] 中国信通院,《数据治理产业图谱3.0》,2023年12月 [5] 国家数据局等,《"数据要素×"三年行动计划(2024—2026年)》 [6] 财政部,《企业数据资源相关会计处理暂行规定》(财会〔2023〕11号) [7] Andrew Ng et al., Data-Centric AI, https://datacentricai.org/ [8] arXiv:2402.05211, Data Catalog

一、行业背景:为什么现在必须谈DCMM贯标 某企业CDO刚完成数据中台建设,董事长在季度会上问:"我们的数据管理水平在行业里排第几?DCMM能过几级?"CDO一时语塞。 中台建好了,但数据管理能力到底怎么样——这个问题越来越多地被问到。三股力量正在把DCMM贯标推向企业议程的核心位置。 第一股力是政策倒逼。 财政部《企业数据资源相关会计处理暂行规定》(财会〔2023〕11号)自2024年正式实施,数据要从"成本项"变成"资产项"。入表的前提是搞清楚数据质量、归属和价值——这恰恰是DCMM评估考察的核心。当CFO开始关心数据管理能力时,DCMM贯标就不再只是IT部门"评个级"的事。 第二股力是标准升级。 DCMM 2.0(GB/T 36073-2025)于2026年7月正式实施,能力域从8个扩展到9个,新增"数据资产"能力域(排第4位),"数据应用"更名为"数据应用流通"。评估标准从"有没有治理"升级为"能不能资产化"——这意味着企业不能再拿旧标准做新评估。 第三股力是竞争压力。 截至2024年7月,全国累计3298家次完成DCMM贯标评估。越来越多的企业将DCMM等级作为数据管理能力的"信用背书"——投标评分加分、合作伙伴准入门槛、集团考核指标。没有DCMM评估等级的企业,在数据能力竞争中正在失去话语权。 二、标准体系:DCMM 2.0九大能力域速览 DCMM 2.0(GB/T 36073-2025)是对企业数据管理能力的全景式评估框架。与1.0(GB/T 36073-2018)相比,有三个关键变化。 1.0→2.0 演进对照表: 维度 DCMM 1.0(GB/T 36073-2018) DCMM 2.0(GB/T 36073-2025) 能力域数量 8个 9个 新增能力域 — 数据资产(排第4位) 命名变更 数据应用 数据应用流通 能力域完整列表 战略/治理/架构/标准/质量/安全/应用/生存周期 战略/治理/架构/资产/标准/质量/安全/生存周期/应用流通 九大能力域速览表: 能力域 类别 核心考察 数据中台承载度 数据战略 战略 是否有规划、有路线图 低(提供支撑,制定靠组织) 数据治理 组织 是否有治理组织、制度、沟通机制 中(提供工具,制度靠人) 数据架构 设计 数据模型、分布、流转是否清晰 高(模型/分布/流转的核心载体) 数据资产 ⭐ 价值 数据是否可盘点、可评估、可入表 高(资产目录/质量评估/价值量化) 数据标准 执行 标准是否制定并执行 高(标准落标、字典管理) 数据质量 执行 是否有质量需求和闭环管理 高(规则/追溯/报告自动化) 数据安全 管控 分类分级、权限、脱敏 中(技术手段,制度靠组织) 数据生存周期 管理 归档、销毁策略 中(配合制度和流程) 数据应用流通 价值 数据是否被使用、共享、产生价值 高(资产门户/API/AI用数) ⭐ = DCMM 2.0 新增能力域,是本次贯标评估的重点增量 九大域中,数据中台直接承载度"高"的有五个域(架构、资产、标准、质量、应用流通),"中"的有三个域(治理、安全、生存周期),"低"的只有一个(战略)。这个分布揭示了一个事实:DCMM评估的大部分能力域,执行层面都依赖数据中台作为技术承载基础。 三、大白话解释:DCMM到底在考察什么 DCMM不是考"平台",是考"能力"。三个常见误区需要澄清。 误区一:"建了数据中台 = DCMM自然高分。" DCMM评估的是"数据管理能力",不是"有没有平台"。没有中台的企业在数据架构、数据标准、数据质量、数据资产这几个域很难拿高分——因为这些能力需要平台承载和执行。但反过来,有中台不等于能力到位:如果元数据没采、标准没落、质量没监控,平台只是一个空壳。DCMM评估师会直接追问:"标准在哪执行的?质量问题怎么追溯?"空壳回答不了。 误区二:"DCMM是IT部门的考核。" DCMM第一条能力域就是"数据战略",第二条是"数据治理"——都是组织层面的事。DAMA将数据治理定义为"围绕数据全生命周期开展的规划、制度、组织、流程与实践活动"。DCMM明确将数据治理组织、制度建设和治理沟通列为核心能力域——数据治理首先是组织治理,其次才是技术治理。没有治理委员会、没有数据管理部、没有制度体系,工具再强也推不动。DCMM 2.0新增的"数据资产"域进一步拉高了组织协同的门槛——资产确认需要财务和业务一起参与,不是IT自己能定的事。 误区三:"过了DCMM评估就万事大吉。" DCMM贯标是起点,不是终点。五级成熟度阶梯中,大多数建了中台的企业在2级(受管理级)——数据集中了、基本治理做了,但标准和质量的执行仍靠人工。从2级到3级(稳健级)需要12-24个月,核心是把标准和质量的执行从"人工"变成"自动"。DCMM 2.0的"数据资产"域更是要求持续运营——资产目录不是一次盘点就完事的,数据每天都在变。资产化是持续过程,评估只是阶段性检验。 四、方法论拆解:"理采存管用"×DCMM 2.0九域系统映射 DCMM是"检查清单"——告诉你企业应该具备什么数据管理能力。理采存管用是"施工图纸"——告诉你这些能力如何通过工程化手段落地。一个是目标,一个是路径。 DCMM 2.0 × 理采存管用 × 中台动作对照表: 理采存管用 对应 DCMM 2.0 能力域 中台动作 关键产出 理 数据战略 → 数据治理 → 数据架构 梳理业务流程、盘点数据资源、建立治理组织 数据资产目录初稿、战略规划 采 数据架构 → 数据生存周期 打通多源异构系统、流批一体数据归集 统一数据汇聚通道 存 数据架构 → 数据标准 数仓分层建模、统一数据模型 标准化数据底座 管 数据治理 / 数据标准 / 数据质量 / 数据安全 元数据+主数据管理、质量规则配置、分类分级、安全管控 治理闭环、质量报告 用 数据资产 → 数据应用流通 资产目录发布、API共享、可视化报表、AI智能用数 业务自助用数、资产价值释放 关键洞察:DCMM 2.0新增的"数据资产"域,在理采存管用中横跨"理"和"用"两个阶段——"理"阶段摸清资产家底(资产盘点),"用"阶段让资产产生价值(资产目录发布、API共享、AI用数)。这正是数据资产化"资源化→资产化→资本化"三步走在方法论层面的体现——从识别资源、到管理资产、再到释放价值,五个字闭环完整覆盖。 龙石数据中台遵循理采存管用方法论进行模块化设计,如图所示,DCMM 2.0九大能力域→五阶方法论→产品模块形成三层映射:国标定目标、方法论定路径、产品定落地。 五、实践映射:数据中台如何支撑六大核心域 在DCMM 2.0九大域中,数据中台直接承载度最高的六个域,每个域有明确的落地路径。 5.1 数据战略 → 数据治理(组织先行) DCMM前两个域考察的是组织能力。中台能做的是提供支撑工具——资产盘点工具(对应"理")、治理流程工具(对应"管")——但战略制定和治理组织建设必须靠企业自己。上海某大型化工企业(案例03)在建设数据中台的同时,成立了数据管理部并设立数据管家岗位,将数据治理纳入绩效考核体系,实现了从"IT项目"到"机制驱动"的转变。这一组织变革本身就是DCMM治理域的加分项。 5.2 数据架构(中台是核心载体) DCMM要求管理数据模型、分布、流转和集成。数据中台通过元数据管理自动建立数据地图,通过血缘分析自动展示数据流转路径。当业务部门想关联分析两个数据域时,立即可见它们的血缘关系——不用再找人问"这数据从哪来的"。架构治理从"靠人记"变成了"系统管"。 5.3 数据资产 ⭐(2.0新增,中台是核心基础设施) DCMM 2.0新增的"数据资产"域考察三项核心能力:数据资产盘点(有什么)、质量评估(值不值钱)、价值管理(怎么用)。数据中台的资产目录模块负责"有什么",质量管理模块负责"值不值钱",资产门户和API共享模块负责"怎么用"。没有中台承载,这三件事靠Excel和人工几乎不可持续——上千张表的数据量、持续变化的数据内容,人工方式无法做到实时更新和动态评估。 5.4 数据标准(从文档到执行) DCMM要求的不只是"制定标准",更是"执行标准"。中台的路径是:在元数据管理模块中定义标准(字段名、类型、值域),数据接入时自动校验合规性,不合规的退回源系统。龙石数据中台在多个项目中通过标准自动落标,将字段合规率从60%提升到95%以上。 5.5 数据质量(从事后救火到持续监控) DCMM数据质量域涵盖质量需求、检查、分析和提升四个过程域。中台的做法是通过旁路监测模式——数据正常入库,质检规则并行扫描,发现问题打标记、发告警、生成工单,不拦截不阻断。江西某国控集团通过建立质量闭环管理机制,半年内将核心数据质量问题的修复周期从两周缩短到两天。 5.6 数据应用流通(让数据产生价值) DCMM的最高要求是"数据驱动决策"。中台支撑这一步的关键是降低用数门槛——资产门户让业务人员用业务语言找数据,AI智能用数让不会写SQL的人也能分析。某市监局通过中台将多个业务条线的数据归集后,统一对外提供数据服务接口,业务部门从"找IT排期"变成了"在线申请、自动审批"。 龙石数据中台严格遵循理采存管用方法论进行模块化设计,各模块既可独立部署也能协同工作。旁路监测模式让质量管控在不侵入源系统的前提下完成闭环——数据正常流转的同时并行扫描,发现异常自动生成工单推动修复。 六、案例验证:从贯标到资产化的真实路径 福建某交投集团 — 数据资产入表 这家负责城市数字化运营的国企,拥有充电系统、调度系统、安防系统等上千张业务表。表面上看数据不少,但一深挖就发现问题——同一类充电桩数据分散在三个系统中,各有各的命名规则。不知道有多少数据、哪些有价值、哪些需要治理。 项目团队采取了"三步走"路径: 第一步:全量数据资产盘点(对应DCMM"数据资产"域—资产盘点)。不谈标准、不谈质量,先把家底摸清楚。通过自动化扫描与业务规则相结合,仅资产目录梳理就涉及上千张表,最终识别出充电订单、支付流水、用户档案、对账记录等核心数据资源,形成了标准化的《企业数据资产目录》。 第二步:建立数据标准体系(对应DCMM"数据标准"域)。统一跨系统的命名规则、编码规范和质量校验标准。在此之前,"同一类数据在三个系统有三种说法"的情况是常态——标准体系建设让数据语言首次统一。 第三步:完成资产质量评估和合规审查(对应DCMM"数据质量"域+"数据资产"域—质量评估)。依托龙石数据质量管理服务,以国家标准《GB/T 36344-2018 信息技术 数据质量评价指标》为框架,对拟入表数据资源进行全量自动化评价,最终质量评价总评分达99.53分。 成果:首批数据资产成功入表,成为福建省某市国有企业中第一批完成数据资产入表的企业。更重要的是——集团第一次真正搞清楚了自己有多少数据、哪些数据有价值。 启示:数据资产入表不是会计问题,是数据治理问题。表能不能入,取决于有没有做资产盘点、有没有做质量评估、有没有建立标准体系。这些恰好是数据中台应该做的事。DCMM 2.0新增"数据资产"域,正是要把这些能力纳入标准化评估——让入表有据可依,让资产化有标可循。 七、FAQ Q1:DCMM 2.0和1.0的核心区别是什么?企业现在按哪个版本准备? DCMM 2.0(GB/T 36073-2025)于2026年7月1日起正式实施。核心变化是能力域从8个扩展为9个,新增"数据资产"能力域(排第4位),"数据应用"更名为"数据应用流通"。当前过渡期建议按2.0准备——因为新增的"数据资产"域需要较长时间建设(资产盘点+质量评估+目录管理),不是短期内能突击完成的。早准备早受益。 Q2:企业建了数据中台,DCMM评估还需要额外做什么? 数据中台解决了平台承载问题,但DCMM评估的是综合能力。有三件事中台本身不能替代:一是战略规划和组织建设(数据战略域、数据治理域需要管理层推动);二是制度体系建设(需要配套管理制度和考核机制);三是持续运营(标准和质量规则需要根据业务变化持续迭代)。中台+制度+组织,三驾马车缺一不可。 Q3:DCMM贯标评估和最近的数据资产入表是什么关系? 数据资产入表(财会〔2023〕11号)是财务侧的合规动作,DCMM评估是数据管理能力侧的标准化评定。两者的交集在DCMM 2.0新增的"数据资产"域——这个域考察的资产盘点、质量评估、价值管理,恰好是资产入表的前置条件。DCMM评估为资产入表提供了"数据是否达到资产标准"的能力验证。做DCMM贯标的企业,在资产入表时会有更扎实的数据基础。 Q4:从启动DCMM贯标到拿到三级证书,一般需要多长时间? 取决于企业数据管理基础。如果已有数据中台底座:从初始级到受管理级(2级),快的6-12个月(补齐基础治理能力);从受管理级到稳健级(3级),通常需要12-24个月——需要把标准和质量从人工变成自动。DCMM 2.0新增"数据资产"域后,三级对资产盘点和管理的要求更高,建议提前布局资产目录建设。关键是持续投入,不是突击冲刺。 本文基于DCMM 2.0(GB/T 36073-2025)国家标准框架撰写,案例数据来自龙石数据项目实践。

2026 年 7 月 1 日,GB/T 36073-2025《数据管理能力成熟度评估模型》(DCMM 2.0)正式实施。相比DCMM 1.0版本,新版标准中能力域由 8 个扩展至 9 个,新增「数据资产」域;能力项由 28 个增至 33 个,评估指标从441条升至486条。 对企业来说,DCMM 2.0 的实施,不只是标准条款的更新。它提醒企业重新回到一个更基础的问题: 现有数据是否清楚、可信、可用,能否支撑数据资产管理、数据应用流通和后续智能化应用。 一、DCMM 2.0—两个方向 三项转变 DCMM 2.0 紧密围绕两个方向展开: 数据要素市场化配置改革方面 DCMM 2.0 构建了覆盖数据「资源化、资产化、要素化」全链条的能力框架,为数据确权、价值评估、资产入表与合规流通提供操作指南。 人工智能深度应用方面 DCMM 2.0 直面智能时代对高质量、高可信数据的迫切需求,强化面向 AI 训练与应用场景的多模态数据治理、高质量数据集建设与管理、数据产品全生命周期管控等能力。 对应这些变化,DCMM 2.0 也体现出三个转向: 从技术实施到业务价值衡量,更加关注数据管理对业务的支撑和量化价值体现; 从人工操作到智能辅助,明确引入人工智能等新技术提升管理效率; 从内部管理到产业生态共建,鼓励参与行业、国家及国际标准制定。 二、对标 DCMM 2.0,先看企业数据现状 公开报道显示,截至 2026 年 6 月,全国已有 11985 家企事业单位完成 DCMM 贯标。 来源:DCMM 2.0 标准推动数据管理向现代化要素新范式升级 —— 访中国电子信息行业联合会副会长兼秘书长高素梅 [N/OL]. 中国电子报,2026-07-03 企业贯标需要全面把握数据治理能力要求,高度关注新增数据资产能力域,突出数据应用与流通的重要性,重视数据安全和生命周期管理,这些方向可以作为企业自我审视的参照。 对于尚未贯标,或者刚开始关注 DCMM 2.0 的企业来说,不必一开始就陷入复杂的指标拆解。 更现实的做法,是先回到自身数据现状,问几个具体问题: 数据资源是否已经盘点清楚? 核心数据的业务定义、责任归属和质量状态是否明确? 跨系统数据口径是否统一? 数据是否能够支撑共享流通、分析应用和后续智能化场景? 数据安全与生命周期管理是否有基本机制? 这些问题的共同指向,并不是简单确认「有没有数据」,而是判断企业现有数据能否形成稳定、可信、可复用的数据供给。 也正是在这个意义上,高质量、高可信数据成为理解 DCMM 2.0 的重要切入点。 如果数据存在大量缺失、错误或不一致,后续无论是数据资产管理、数据应用流通、安全与生命周期管理,还是 AI 训练与分析应用,都会缺少可信的数据基础。 三、龙石数据质量管理平台·社区免费版带你建立DCMM自查起点 企业对标 DCMM 2.0,直接从9大能力域同时铺开,往往成本较高,也不容易在短时间内形成具体判断。 相比之下,数据质量更适合作为一个轻量入口。 数据质量直接关联企业数据是否完整、准确、一致、规范、及时,也会影响后续的数据标准建设、数据资产管理、数据应用流通和智能化应用。 企业可以先选择一批真实业务数据,围绕数据质量开展一次评测,初步判断数据本身是否可查、可信。 评测对象:可以结合企业自身业务场景选择,比如客户主数据、供应商主数据、物料数据、订单数据或财务指标数据,或者当前使用频率较高、问题暴露较多的数据表。 评测维度:可参考 GB/T 36344-2018《信息技术 数据质量评价指标》的框架,围绕规范性、完整性、准确性、一致性、时效性等维度展开。 以龙石数据质量管理平台·社区免费版为例,企业可以围绕数据质量评测的基础流程,快速完成规则配置、数据评测和报告输出。 在评测规则方面,平台支持完整性、准确性、一致性、规范性、时效性等维度的数据质量规则可视化创建,内置十余类常见质量检测规则,包括:空值检查、重复值检查、唯一性检查、格式规范检查、引用完整性检查、长度校验等. 在数据评测方面,平台采用旁路非侵入式监测模式,基于分布式计算引擎,支持定时触发与即时触发,兼容全量检测与增量检测,并完整保留评测任务日志。 在问题数据方面,平台可按主题、部门、规则查看质量评测报告与修复成效,帮助企业将数据问题转化为可查看、可分析、可持续跟踪的评测结果。 四、从真实数据出发,推动数据管理能力持续提升 这次质量评测可以为企业后续数据资源化、资产化、要素化工作提供几类问题线索: 哪些数据已经被盘点、有记录、可追溯,哪些数据还没有统一的底账; 核心数据是否具备基本的质量保障和业务定义清晰度,能否支撑后续资产目录建设和价值评估; 数据是否能支撑共享、分析、AI 训练或业务决策场景,是否具备进入数据产品和高质量数据集的条件; 数据质量评测只是一个实践入口,它的价值不在于得出一个分数,而在于帮助企业看清现状,并进一步判断数据标准、数据质量、数据资产管理和数据应用流通等相关工作的后续治理重点。

一、场景切入 某集团数据中台上线半年,在一次月度经营会上,CEO抛出一个问题:"我们的数据能力现在到底什么水平?"会议室安静了十秒。数据接进来了,报表也跑起来了,但问到"数据标准化覆盖率""质量问题闭环率""元数据血缘完整度",答案全是"大概""应该""差不多"。 CIO想起年初规划中提到要申请DCMM贯标评估,于是安排内部先自测一轮。结果发现,比"达不到评估标准"更尴尬的是——团队连一套面向中台建设场景的自评标准都拿不出来。数据中台建了,但没有一把衡量中台能力状态的"尺子"。 这个场景并不罕见。据调研,超过六成的数据中台项目在上线后的一年内,团队对"建到了什么程度、下一步该往哪走"缺乏量化的判断依据。问题实质是:中台是工具,成熟度是能力,工具上线不等于能力就位。 二、标准锚定:DCMM给出了方向 要回答"数据能力什么水平",国家标准 DCMM(数据管理能力成熟度评估模型)提供了一个完整的参考框架。 DCMM 2.0(GB/T 36073-2025)于2026年7月1日起正式实施,将企业数据管理能力划分为九个能力域——数据战略、数据治理、数据架构、数据资产(2.0新增)、数据标准、数据质量、数据安全、数据生存周期和数据应用流通。成熟度分为五级:初始级、受管理级、稳健级、量化管理级和优化级,形成从"数据分散、手工出报表"到"治理规则自优化、AI辅助决策"的能力阶梯。 根据中国电子信息行业联合会的数据,截至2024年7月,DCMM贯标评估累计完成3298家次,数据管理能力正在成为衡量企业数字化水平的硬指标。DCMM考察的是企业级数据管理能力,覆盖战略、组织、制度、技术全维度。其评估面广,评估逻辑严谨,因此周期较长、门槛较高。 对于大多数已经建设或正在建设中台的企业,日常更迫切需要回答一个更聚焦的问题:我建的数据中台,到底做到了什么程度?DCMM是国标,告诉你"数据管理能力应该达到什么水平";本文提出的模型是你的日常自检清单,聚焦数据中台五个命脉维度的能力状态。 三、模型提出:数据中台成熟度的五芒星 本文提出的成熟度自评模型包含五个维度,彼此之间不是并列关系,而是有内在的递进逻辑: 主数据一致性是地基——同一个业务实体在所有系统里叫同一个名字。数据根基不牢,上层所有分析都是沙上建塔。 数据标准化是框架——命名有规范、编码有规则、口径有共识。标准定了,数据才可能在不同系统之间"对话"。 元数据贯通是运行——数据从哪来、经过了哪、去到哪,全程可追溯。数据流得动,治理才能跟上。 质量管控是保障——数据不仅要"有",还要准、全、一致、及时。再好的架构也撑不住"脏数据"。 资产目录与服务化是价值出口——业务人员能用业务语言找到数据、拿到数据。前面四个维度的投入,最终要通过这一维度转化为业务价值。 这五个维度的逻辑链条可以概括为:先有统一的"说法"(主数据),再建统一的"规矩"(标准),然后让数据"流起来"(元数据),保证数据"信得过"(质量),最后让业务"用得上"(资产目录)。每个维度都给出五个等级的自评标准,企业不需要等官方评估,对照就能完成一轮自我诊断。 四、维度拆解 从数据地基说起:你的主数据还在"一物三名"吗? 江苏某建筑装饰集团旗下有200余家子公司,项目遍布全国。供应链部门发现一个反复上演的场景:每次跨公司调拨材料,都得先打电话确认名称——苏州叫"大理石A级",南京叫"A类石材",杭州又叫"天然大理石A"——同一个东西三个名字,光是对清楚"谁说的到底是什么"就要打一圈电话。集团层面做跨公司对账,光是搞清楚材料名称的对应关系就要花三五天。 这不是个别现象。主数据不一致是企业数据治理中最基础也最隐蔽的问题——它不报错、不宕机,但会让一切跨系统分析变成"鸡同鸭讲"。 主数据一致性五级自评: 等级 表现 1级 各系统编码各自为政,没有主数据管理意识,同一实体存在多套独立编码 2级 识别了核心主数据实体(物料、供应商、客户等),但编码规则未统一执行,存在"有标准但没人用"的情况 3级 统一编码规则并完成主要系统的落标执行,跨系统可查询唯一编码,对账实现自动化 4级 主数据变更可控——新增和修改有审批流,同步机制覆盖全链路,数据一致性实时校验 5级 主数据治理与业务流程深度融合,数据变更自动触发业务规则调整,主数据成为业务协同的"通用语言" 上述建筑装饰集团完成统一物料编码后,跨公司对账周期从5天压缩至1天,因数据不一致引发的业务纠纷减少80%,项目平均工期缩短约10%。这印证了一个基本判断:主数据不统一,跨系统分析就失去基础。 编码统一只是第一步。数据的"共同语言"不仅包括编码,还包括字段命名和指标口径——这是标准化维度要解决的问题。 编码只是第一步:你的数据有"共同语言"吗? 上海某大型化工企业的情况更具代表性:MES系统里的"订单交付时间"从排产确认开始计算,ERP里的同一指标从出库扫码开始计算。管理层月度经营会的前半小时,几乎每次都是争论"到底哪个数是对的"。两个系统都没错,但口径不一致,数据就是"噪音"。 标准化最容易被误解为"出一套命名规范文档"。真正的问题是文档落不了地——标准写在Word里,数据跑在系统里,两者之间没有桥梁。 数据标准化五级自评: 等级 表现 1级 无统一数据标准,字段命名全凭开发人员习惯,同一含义的字段在不同表中有不同命名 2级 制定了数据元标准和字典规范文档,但停留在纸面,未与平台打通,标准执行靠人工检查 3级 标准在数据中台内落标执行,数据接入时自动校验字段命名、格式、值域合规性,不合规数据被标记 4级 标准覆盖全业务域,不合规数据有"反馈→修正→复验"的完整闭环,标准化覆盖率可量化 5级 标准随业务演进自动维护和更新,新系统上线时即对标数据标准,标准成为数据治理的"基础设施" 上述化工企业在建立数据标准体系并打通OT/IT链路后,订单交付及时率提升至91%。在多个项目中,通过标准自动落标机制,数据字段合规率从60%左右提升到95%以上。 标准定了、编码统了,但数据到底从哪来的、经过了什么加工步骤——这需要元数据贯通维度的能力。 数据流得动吗:你的元数据是"活地图"还是"死文档"? 技术团队里有一个高频对话:"这个报表里的'活跃客户数'到底是从哪个系统取的?中间经过什么计算逻辑?"回答通常是翻出一份上线时写的接口文档,然后发现文档里的表结构已经和实际差了三个迭代。元数据只有上线那一版是准的,之后就成了"死文档"。 元数据的核心价值不是"知道有什么表和字段",而是"知道数据的来龙去脉"——数据从哪来、经过了哪、去到了哪、每一步做了什么变换。这直接关系到数据问题排查效率和数据变更的风险控制水平。 元数据贯通五级自评: 等级 表现 1级 无元数据管理,数据含义靠核心开发人员口口相传,人员变动即知识断档 2级 采集了基础元数据(表结构、字段定义),但依赖手工录入,与实际数据库状态存在时差 3级 元数据自动采集和血缘解析上线,数据地图实时更新,支持一站式检索和溯源查询 4级 血缘覆盖全链路——源系统→ETL→数仓→报表/API,变更影响分析自动化,改一张源表能自动识别下游影响范围 5级 元数据驱动数据治理自动化——质量问题可自动溯源到元数据,标准变更自动向下游传播影响提醒 前述化工企业通过工业数据湖打通OT/IT全链路数据模型后,报表出具周期提前4天。另一个化工项目在完成血缘分析能力建设后,业务人员可以在资产门户中自助检索数据,IT部门的数据答疑工作量显著下降。 数据能溯源了,但它"干不干净"——质量管控维度回答数据可信度的问题。 数据进了中台,你敢信吗:质量管控的三道关 数据质量是"沉默的杀手"。一个字段的缺失或异常可能在生产环境里潜伏六个月不被发现,直到某天CEO在董事会上引用的数据恰好来自那张表——那时问题已经从技术层面上升到信任危机。 质量管控不能靠"人工抽查",也不能走"拦截式"——在数据量大、实时性要求高的场景下,入库前逐条校验会拖垮链路。一种在实践中被验证有效的模式是旁路监测:数据正常入库,质检引擎并行扫描,发现问题打标记、告警、生成工单,不拦截不阻断。流和检分开,保障效率的同时守住质量底线。 质量管控五级自评: 等级 表现 1级 无系统性质量规则,数据"进来了就行",质量问题靠下游使用者偶然发现 2级 配置了基础质量规则(非空、格式、值域),但告警发出后缺少跟进机制,问题积压 3级 质量闭环形成——"发现→定位→修复→验证",质量趋势可视化,问题可追踪到人 4级 质量规则覆盖入库和使用双环节,业务人员使用数据前可查看质量评分,低质量数据有使用限制 5级 质量规则自适应调整,问题出现前即可预测和主动治理,AI辅助异常模式检测 上海某数据局的质量治理提供了规模化治理的参照:部门数据初始目录合格率仅6.34%,通过建设1000余条监测规则和闭环治理机制,目录合格率提升至94.74%,整体合格率达到99.93%。江苏某大数据中心建立了200余个数据元标准,对300余个高频数据资源进行全面评测,累计处理10亿条数据,定位近1000万个质量问题,修复率达95%。 部分产品如龙石数据中台采用旁路监测模式实现质量管控自动化,质检引擎与入库链路解耦,企业可按需配置规则、渐进式推进治理,避免"硬着陆"式的质量整改。 数据干净了、可追溯了、标准统一了——但如果业务人员找不到数据、拿不到数据,前面所有投入的价值都会悬在半空。最后的收口在资产目录与服务化。 最后一公里:你的人能不能自己找到数据、用上数据? 江苏某211大学的信息化场景是这一维度的典型缩影:旧数据平台超期服役,师生如果需要一个跨部门的数据——比如学生成绩与图书馆借阅记录做关联分析——要走纸质申请、逐级审批,跨多个处室盖章,周期按天甚至按周计算。数据明明在系统里,就是"取不出来"。 资产目录与服务化要解决的本质问题,是让数据从"IT部门保管的东西"变成"业务部门能用的资源"。这要求前四个维度(主数据一致、标准统一、元数据贯通、质量可信)已经打下了基础——否则资产目录只是一张"垃圾地图"。 资产目录与服务化五级自评: 等级 表现 1级 无数据目录,找数据靠"在群里@IT",IT部门是数据流通的唯一通道 2级 有Excel版数据资源清单,但更新滞后,数据和清单对不上,可信度低 3级 在线资产门户建成,支持业务语言检索,数据申请流程线上化,审批透明可追踪 4级 数据产品化——API封装和数据集发布形成常态,按业务场景推荐数据资源,使用率可量化统计 5级 AI智能体驱动——自然语言问数,找资源、问数据、问知识全链路自助,数据消费者完全脱离IT依赖 上述大学实施数据探查编目、建设数据超市和数据网关后,跨部门数据申请从"天/周级"缩短至"分钟级"自助获取。江苏某市监局通过API自助共享和企业画像能力建设,监管人员日均登录系统次数减少90%以上。 部分产品如龙石数据中台,在资产目录模块中构建了数据超市和API自助共享能力,让业务部门从"找IT排期"变成"在线申请、自动审批"。但工具只是载体,资产目录能否真正"好用",取决于前四个维度的数据基础是否扎实——主数据统一、标准落地、元数据完整、质量可信,资产目录才有"好数据"可索引。 五、全貌验证:一个案例看五维度 将五维度模型回看前述化工企业案例,可以得到一个完整的横截面扫描: 维度 该企业的实际表现 评估等级 主数据一致性 统一物料编码,全集团产销协同调拨 3级 数据标准化 建设数据标准体系,打通OT/IT标准壁垒 3级 元数据贯通 构建工业数据湖,全链路数据模型支撑 3级 质量管控 成立数据管理部,以组织机制驱动质量治理 3级 资产目录与服务化 产销协同驾驶舱、领导驾驶舱上线,业务自助分析 3级 综合评估,该企业数据中台整体处于"稳健级"——治理形成了闭环,业务开始真正使用数据。在具体成效上,库存周转率提升28%,订单交付及时率提升至91%,报表出具周期提前4天。 从"稳健级"迈向"量化管理级"的关键一步是:为每个维度建立可量化的评估指标——如资产使用率、质量趋势图、业务贡献度系数等,从"知道做好了"升级到"能证明做到了什么程度"。 六、行动指南:从当前级到下一级 成熟度提升不需要追求五个维度同步跃迁,每个维度都有最低可行动作和参考周期: 进阶路径 最关键的一个动作 参考周期 主数据 1→2 拉出一张核心实体清单(物料/供应商/客户),逐系统梳理编码冲突 1-2周 主数据 2→3 选取一个数据域统一编码并在中台平台落标执行 1-3月 标准化 1→2 为核心业务字段制定数据元标准文档,明确命名、格式、值域规范 2-4周 标准化 2→3 标准规则嵌入平台,数据接入环节自动校验合规性 2-4月 元数据 1→2 手工采集核心系统的表结构和字段信息,形成第一版元数据清单 1-2周 元数据 2→3 配置自动元数据采集调度和血缘解析引擎 1-3月 质量 1→2 配置5-10条基础质量规则(非空、格式、值域),开启自动扫描 1-2周 质量 2→3 建立"发现→定位→修复→验证"闭环机制,指定责任人 3-6月 资产目录 1→2 梳理并发布数据资源Excel清单,覆盖核心业务数据 1-2周 资产目录 2→3 建设在线资产门户,支持业务语言检索和自助申请审批 1-3月 核心建议有三条。其一,优先选一个高业务价值的数据域跑通全维度闭环(例如供应链域从主数据编码到资产目录自助用数),验证方法论后再横向扩展。其二,参考DCMM贯标评估的实践节奏——从初始级到受管理级快则6-12个月,受管理级到稳健级通常需要12-24个月,这为各阶段设定了合理的预期。其三,成熟度提升的关键瓶颈不是技术升级,而是把标准和质量的执行从"人工操作"变成"自动校验",从"运动式突击"变成"日常化习惯"。部分产品如龙石数据中台配套"三层培训+三步陪跑"全周期赋能模式,帮助团队从"会用工具"到"会建体系",降低成熟度跃迁过程中的人员门槛。 七、FAQ Q1:这个模型和DCMM是什么关系?我需要两个都做吗? DCMM(GB/T 36073-2025)是国家标准,评估企业整体的数据管理能力——覆盖战略规划、组织治理、制度流程、技术工具等全维度,是正式的评定体系。本文的五维度模型是面向数据中台建设场景的自检工具,聚焦平台能力的五个命脉维度,适用于日常快速诊断。 两者不冲突,而是互补:DCMM告诉你"企业数据管理能力应该达到什么水平",本文模型告诉你"中台这五个维度当下做到了什么程度"。建议先用本文模型完成一轮自测,识别短板,再有针对性地对照DCMM框架补全组织、制度等非技术维度。 Q2:我们中台刚上线,五个维度都只能打1-2级,是不是起点太低了? 这是正常状态。从初始级到受管理级是最快的阶段——核心任务是建立认知和基础规范,不是技术攻坚。建议先集中力量攻克"主数据一致性"和"数据标准化"两个维度:拉出核心实体清单,定下编码规则,在中台平台完成落标。这两个维度是其余三个维度的前提——主数据不一致,质量管控无从谈起;标准不统一,元数据贯通就是乱序。 Q3:五个维度必须同时推进吗? 不建议。五个维度有内在顺序——主数据和标准是地基,元数据是运行基础,质量是保障,资产目录是收口。同时推进容易出现"每个维度都沾了边、每个维度都没做深"。建议先完成两个地基维度,跑通一个数据域的闭环,再用同样的方法推动其余三个维度。 Q4:怎么判断我们是否准备好申请DCMM正式评估? 五个维度都达到3级(稳健级)以上是一个比较可靠的内测信号——这意味着数据标准和质量的执行已从"人工"进入"自动",治理形成了闭环,业务真正在用数据。但DCMM评估的考察范围更广,还涉及组织治理、数据战略、制度建设等领域。建议在五维度达3级后,补充完成数据治理委员会设立、数据管理制度完备、数据安全体系搭建等组织层面工作,再正式启动贯标评估。 参考来源 GB/T 36073-2025《数据管理能力成熟度评估模型》(DCMM 2.0),2026年7月1日起实施 DAMA International,《DAMA-DMBOK Data Management Body of Knowledge (2nd Edition, Revised)》 中国电子信息行业联合会,DCMM贯标评估年度报告,202
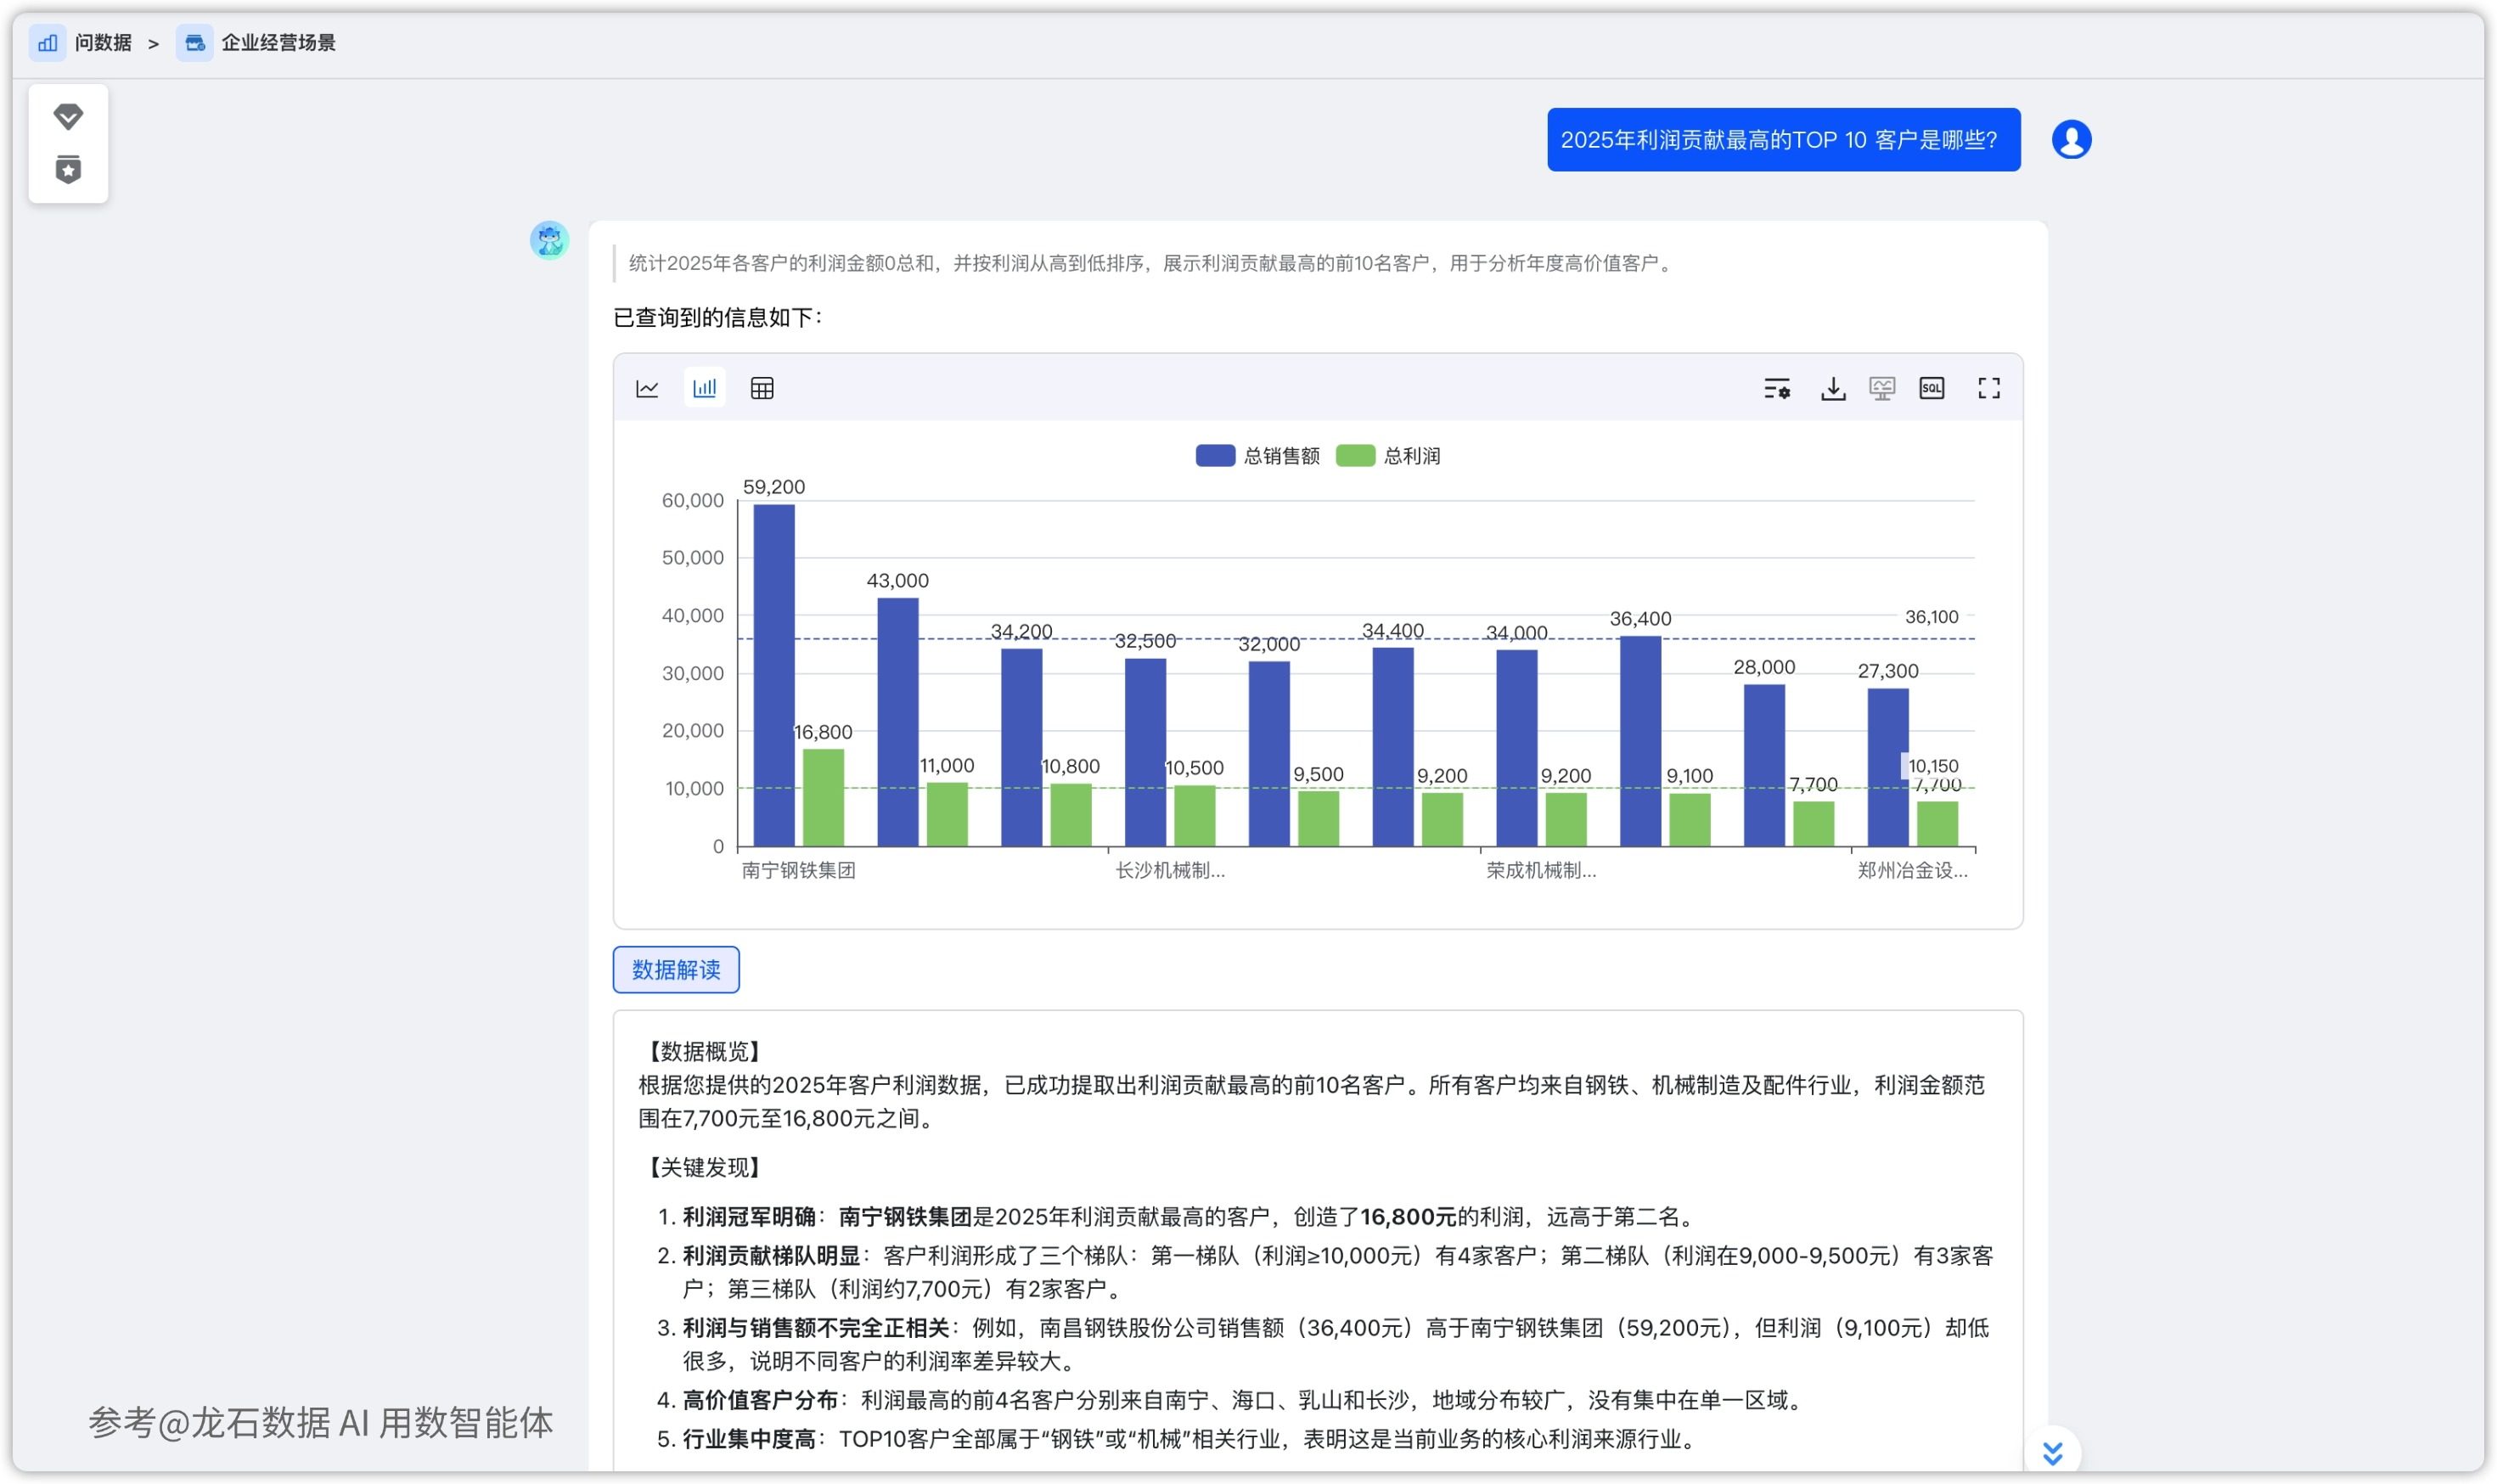
一、场景介绍 销售总监老李周一早会前打开ERP系统,想快速查一组数据:"各区域本月销售额完成率是多少?和上个月环比变化怎么样?再拉出近六个月的月度趋势看看。"他打开BI工具点了半天,发现需要的维度分散在三个不同的报表里,做交叉分析得先导出Excel再手动合并。他给IT部门发了条消息,很快收到回复:需求已收到,排期大约三天后给结果。下周一的事情,周一才能拿到数据,老李看着手机叹了口气。 这不是老李一个人的问题。在大多数企业的实际工作场景中,业务人员想查询分析数据的路径是固定的:提需求、等排期、IT写SQL(Structured Query Language,结构化查询语言)、返回结果、发现不对、再沟通、再等。一个简单的问题来回几天是常态,复杂一点的交叉分析等一两周也不罕见。数据明明就存储在系统里,但业务人员就是拿不到、用不起来——技术门槛把数据的使用权牢牢锁在了IT部门手中。 这个问题背后更深层的矛盾在于:企业花大量资源建设数据平台、打通数据孤岛、汇聚数据资产,最终的目的是让数据服务于业务决策。但如果业务人员每一次查数据都必须经过IT翻译,数据中台建设得再好也只是IT团队的后台工具,距离真正赋能业务还差最后也是最关键的一步——让不懂SQL的人也能直接用数据。 二、前置条件:AI读懂数据的四项基础 AI智能用数(即通过自然语言对话的方式查询和分析企业数据)不是在空白系统上装一个聊天界面就能跑通的。一个用户输入"本月华东区销售额排名",AI需要完成一系列动作:理解用户意图、定位相关数据表、确认字段含义、生成查询语句、返回结果并解读——这个链条的每一步都依赖于数据治理底座的支撑。说得更直白一点:AI不是魔法,它需要知道企业有哪些数据、数据是什么意思、能不能信得过。以下四项基础能力,是AI用数能否跑通的前提。 2.1 数据资产目录——让AI知道"有哪些数据" 数据资产目录(即对企业全部数据资源的系统性编目和索引)在AI用数场景下的角色发生了根本变化。过去,资产目录更多是一份给管理层汇报的"全景图"——展示企业有多少张表、多少项指标、覆盖了哪些业务域。但在AI用数场景中,资产目录变成了AI的导航地图。当用户用自然语言问"本月华东区销售额",AI需要在资产目录中完成定位:销售额数据存在哪张表里、华东区对应哪些字段、这些表和字段之间是什么关系。目录全不全、目录里的元数据描述准不准,直接决定了AI能不能找到正确的数据。如果核心业务表根本没有纳入目录,AI的表现就是"未找到相关数据"——这不是模型能力不行,而是模型根本不知道数据在哪。正如数据目录领域的研究文献所指出的,数据目录是数据资产化的重要入口(arXiv 2402.05211),在AI驱动用数的场景中,这一入口的作用被进一步放大。 2.2 元数据管理——让AI理解"数据是什么意思" 元数据(Metadata)即"关于数据的数据",通俗地说就是数据的"使用说明书":这个字段叫什么名字、从哪个业务系统来、在业务中代表什么含义、数据类型和取值范围是什么。举个例子,一个字段名叫customer_name,如果不标注元数据,AI只知道这个字段存的是字符串。但如果标注了元数据——"此字段为ERP客户管理模块中的签约客户全称,与CRM系统中的company_name字段对应同一个业务实体"——AI就能在用户问"客户签约情况"时准确关联到这个字段。当同一个概念在不同系统中的叫法不同(比如ERP系统叫"客户名称",CRM系统叫"签约主体",财务系统叫"往来单位"),元数据层负责统一这些语义差异,为AI提供一个一致的"翻译层"。没有这个翻译层,AI永远读不懂企业数据的真实含义。 2.3 语义模型与数据标准——让AI跨系统理解业务 数据标准统一了核心业务实体的编码规则和口径定义。但更关键的是语义层面——不同业务系统对同一个概念的"口径"可能完全不同。以"销售额"为例:ERP系统按含税签约金额计算,财务系统按不含税实收金额计算,CRM系统按销售机会预估金额计算。三个系统明明都在说"销售额",数字却对不上。如果这些口径差异没有在语义模型层面统一对齐,AI就只能忠实地汇总它能找到的数据——而它找到的数据本身口径就不一致。这就是为什么制造企业在用大模型查"华东区销售额"时,模型返回3200万、财务系统显示2800万的典型案例:不是模型算错了,是模型取得的数据口径源头就不统一。语义模型的价值就在于为AI提供一个统一的业务语义定义层,让"销售额"在企业内部有唯一且明确的含义。 2.4 数据质量——让AI输出的结果可信 数据质量(Data Quality)即数据的准确性、完整性、一致性和及时性,在AI用数场景中是最先暴露的问题,也最容易被人误判为"模型不行"。大语言模型的一个特征是对输入数据的"信任"——它不会主动质疑数据来源的可靠性,脏数据(缺失值、错误记录、重复数据)会被模型当作事实全盘接受,然后生成流畅但可能完全错误的分析结果。根据Data-Centric AI(以数据为中心的人工智能)的研究观点,AI系统的效果上限由数据质量决定,而非单纯由模型能力决定。在传统数据分析场景中,分析师面对一份脏数据至少还能凭经验识别异常值;但在AI自动查询分析的链路中,脏数据绕过人工审核直接进入结果,修复成本反而更高。龙石数据中台采用旁路监测模式应对这一挑战:数据正常入库不阻塞业务流转,质检规则在旁路并行扫描,发现问题后自动标记、告警并生成质量工单,在不影响业务时效的前提下持续提升数据质量的可见性和可管理性。 三、配置实战:让AI听懂销售问题 以下配置流程基于龙石AI用数智能体的管理端功能,覆盖从创建场景到发布上线的完整路径。每一步均可独立执行,读者可按顺序逐步操作。文中涉及的术语在首次出现时标注了中文解释。 3.1 步骤1:创建用数场景 目的:为"问数据"智能体定义工作上下文——关联哪个数据源、使用哪套指标体系、遵循什么样的分析规则。一个场景就是一个对话沙盒,用户进入不同场景就进入不同的数据工作区。 操作:进入智能体管理→数据知识管理→创建场景。填写三项核心信息:场景名称(如"销售数据分析"),场景描述(如"覆盖订单、回款、退货、客户维度,支持区域/产品/人效多维度分析"),关联业务领域。场景创建完成后,系统为该场景开辟独立的数据知识空间。 3.2 步骤2:接入元数据 目的:让AI知道该场景下可查询哪些数据表、每张表有哪些字段、每个字段的业务含义是什么。 操作:在数据知识管理中配置元数据源,系统自动采集关联数据库中的表结构、字段名称和字段类型。采集完成后,运营人员需为每个字段逐项补充业务含义说明——不只是写"字符串类型、长度50",更要写清楚"这个字段在业务中代表什么、从哪个系统来、计算口径是什么"。同时设置字段启用状态:核心业务字段设为"可查询",敏感字段(如客户联系方式、身份证号等)设为"不可查询",实现字段级别的数据权限控制。 3.3 步骤3:提示词模板与召回测试 目的:引导大语言模型按照企业规范生成SQL和回答。提示词(Prompt)即发送给大模型的结构化指令文本,定义了AI的角色、行为边界和输出约束。 操作:平台内置了默认的提示词模板和召回测试机制,一般情况下直接使用即可。在提示词管理中可以查看和微调,但新手上路不必从头编写——默认模板已覆盖角色设定和基本的SQL生成规范。配置完成后,在测试界面输入几个真实的业务问题(如"本月各区域销售额排名"),观察AI返回的结果是否符合预期。如果结果偏差较大,再针对性地调整提示词或重新检查元数据标注,不必一开始就追求"完美"。测试覆盖单表查询、多表关联、聚合统计等几个典型场景即可。 3.4 步骤4:预设高频问题 目的:对企业内最高频的业务查询问题提前配置标准查询语句,确保这部分问题的回答准确率达到100%。 操作:收集业务部门最常问的销售数据问题,按分类录入预设问题库。常见分类包括区域销售分析(如"本月各区域销售额排名""各区域完成率对比")、产品分析(如"各产品线销量排行""产品毛利率分布")、人效看板(如"各团队人均产出""销售个人业绩排名")、趋势分析(如"近六个月月度销售趋势""同比环比变化")。每个预设问题配置对应的标准查询语句和预期回答格式。用户在前端使用时可点击预设问题直接查询,无需手动输入。 3.5 步骤5:发布上线 目的:将配置好的智能体和场景从管理端发布到应用端,面向业务用户开放使用。 操作:配置智能体的前端展示信息——名称(如"销售数据助手")、图标、描述和开场白(如"请输入您想了解的销售数据问题")。配置场景切换选项,使用户可以在不同业务场景之间灵活切换。确认用户权限分配:按角色设置数据库、表、字段级别的访问范围(如销售一部只能看到对应区域的客户和订单数据,销售总监可以看到全部数据)。设置用户配额(如每人每日200次查询),控制大模型调用成本。所有配置确认无误后,点击发布。 四、配置模板(核心模块) 以下配置模板汇总了步骤3.1至3.5中涉及的关键配置项,供读者在实际操作时参照使用。每个配置项均标注了推荐填写内容和配置说明。 配置项 填写内容 说明 场景名称 销售数据分析 按业务域命名,用户在前端切换场景时可见 场景描述 覆盖订单、回款、退货、客户维度,支持区域/产品/人效多维分析 描述场景覆盖的数据范围和可分析的维度,帮助用户理解该场景的适用边界 关联数据源 sales_db(含订单表、回款表、客户表、区域表) 选择该场景下可查询的数据库和数据表,未关联的数据源对AI不可见 元数据接入 自动采集表结构,逐字段补充业务含义说明 每字段须标注业务含义,仅靠字段名AI无法正确理解数据含义 字段权限 客户名称、签约金额→开启;客户联系方式→关闭 敏感字段设为不可查询,从源头阻断数据泄露风险 提示词模板 使用平台默认 平台内置了角色设定和SQL生成规范,新手上路直接用默认即可 预设问题 "本月各区域销售额排名""近6月月度销售趋势""客户回款率分析""各产品线销量排行" 高频问题预置标准查询,该类问题准确率可做到100% 用户权限 销售部门全员→查询权限;销售总监→全部字段访问权限 按角色分配数据访问范围,遵循最小化原则 用户配额 每人每日200次查询 控制大模型Token消耗成本,可根据岗位调整 智能体外观 名称"销售数据助手",开场白"请输入您想了解的销售数据问题,如:本月各区域销售额排名" 增强用户辨识度,开场白引导用户发起查询 五、验证结果:自然语言查询实战 配置完成并发布上线后,业务人员打开"销售数据助手"智能体,即可以自然语言对话的方式查询和分析销售数据。以下展示三个典型查询示例,呈现AI用数在实际业务场景中的效果。 查询示例一:单维度排名统计。 用户输入"本月各区域销售额排名",AI经过意图识别→数据表定位→SQL生成→结果返回的完整链路,输出华东、华南、华北、西南等各区域的销售额排名表格,同时自动生成一张柱状图直观呈现各区域对比,并配以文字解读:"本月销售额最高为华东区(1,280万元),其次为华南区(965万元),西南区环比增幅最大(+12.3%)。整体完成率为82%,与上月同期相比增长5.2个百分点。" 查询示例二:多维度趋势分析。 用户输入"近六个月月度销售额趋势,按产品线分类",AI返回一张趋势折线图,六条产品线(A/B/C/D/E/F)各自呈现近六个月的月度销售额变化曲线,下方附带明细数据表。文字解读自动提炼关键特征:"六条产品线中,B产品线和D产品线呈现持续上升趋势,B产品线近六月累计增长34%;C产品线在第四个月出现明显下滑(环比-18%),建议关注原因。" 查询示例三:交叉维度分析。 用户输入"分析一下上季度客户回款率,按区域和大客户/中小客户分类",AI返回分组柱状图——横轴为区域,每组两根柱子分别代表大客户回款率和中小客户回款率。文字解读标注关键发现:"整体回款率82%,其中大客户回款率(91%)显著高于中小客户(74%)。华北区大客户回款率最低(79%),建议重点关注该区域大客户的回款跟进。" 上述查询结果的共同特征是:数据表格提供精确数值,可视化图表提供直观对比,文字解读提炼关键洞察——用户在不需要理解任何SQL语法或数据结构的前提下,通过自然语言对话完成了过去需要IT协助数日才能完成的分析工作。龙石AI用数智能体在返回数据结果的同时,自动生成自然语言描述对数据的关键特征进行提炼与解释,降低了业务人员理解数据结果的门槛。 六、避坑指南 AI用数在实际落地过程中,有三个高频踩坑点。以下逐一拆解现象、根因和解法。 坑一:元数据不全,AI"读不懂"数据。 现象:智能体配置完成、成功发布上线后,用户输入"本月销售额",AI回复"未找到相关数据",或者查询了错误的表返回了毫不相干的结果。根因:元数据接入不完整——数据表确实接入了,但字段的业务含义没有标注。AI只知道字段名叫sales_amount、类型是decimal(18,2),但它不知道这个字段代表的是"含税签约金额"还是"不含税实收金额",不知道它对应的是哪个统计口径,甚至不确定它在不同表中是不是同一个含义。在这种情况下,AI要么拒绝回答,要么给出一个看似合理但实际错误的答案。解法:元数据接入环节必须逐字段标注业务含义,不能只停留在字段类型和长度这些技术元数据层面。要把每个字段在业务中的含义、来源系统、计算口径写清楚,这一步做得越扎实,后续AI用数越可靠。这不是一次性工作,后续新增的数据表和数据字段也需要同步维护更新。 坑二:数据口径不统一,AI输出"看着对、实际错"。 现象:销售总监用AI查"本月销售额"得到3200万,觉得数据还不错。但财务部门出具的月度经营报告显示销售额2800万,差距400万。AI给出的数据"看着对"——格式规范、数字精确、图表美观——但"实际错"——和权威数据源对不上。根因:同一个"销售额"指标在不同的业务系统中口径不一致。ERP系统按含税签约金额计算,财务系统按不含税实收金额计算,CRM系统按销售机会预估金额计算。AI只是在忠实地汇总它能找到的数据,但这些数据源自不同口径,汇总本身就没有意义。解法:在数据标准层面统一核心指标的口径定义,明确"销售额"在企业内的唯一计算规则。如果多个口径在业务上都有存在的必要性,则必须用不同的指标名称加以区分(如"含税签约销售额""不含税实收销售额"),确保AI引用的每个指标在语义上单一、明确、无歧义。语义模型的建设是这道门槛的关键——它决定了AI是"理解业务"还是"堆砌数据"。 坑三:只配工具不建运营机制,"上线即终点"。 现象:智能体上线首月使用活跃,业务人员觉得新鲜纷纷试用。三个月后再看数据,日活跃用户大幅下滑,少数仍在使用的用户偶尔提问发现回答不对,不知道找谁反馈,默默放弃。智能体从"新工具"变成了"僵尸系统"。根因:AI用数不是一次性配置项目,而是一个需要持续运营的能力平台。没有用户反馈收集机制、没有问答质量监控、没有人持续优化提示词和元数据标注——智能体上线后不会自己变聪明,它只能停留在配置时的初始水平。解法:建立"用户反馈→工单处理→知识库更新→模型优化"的运营闭环。具体而言:用户对智能体回答结果可点赞或点踩,点踩记录自动生成反馈工单推送至数据治理团队;运营人员复核处理后,将优化结果更新至提示词模板或元数据标注;定期分析高频失败问题,系统性改进薄弱环节。运营闭环是AI用数从"能用"走向"好用"的关键机制。 七、小反转:真正决定效果的不是配置 看到这里,你可能会认为AI用数就是按照上面的六个步骤逐一配置、反复调优。配置本身确实不复杂——创建场景、接入元数据、编写提示词模板,有经验的运营人员几天之内就能完成部署。但真正决定AI用数效果的,不是提示词写得有多精妙、模型参数调得有多细致,而是配置背后数据治理的成熟度。 资产目录不完整,AI就找不到数据——这和提示词质量无关。元数据没有标注业务含义,AI就读不懂数据——这和模型能力无关。数据标准不统一,AI输出的结果就是"看着对、实际错"——这和查询逻辑无关。数据质量无人管理,AI给出的分析结论就不可信——这和算法精度无关。AI用数的上限,不由大模型的能力决定,由企业数据治理的成熟度决定。龙石AI用数智能体的一个核心设计前提是:数据治理到位后AI用数效果才好——治理的底子,不能省。 八、案例验证:一个已经跑通的样本 江苏某国企数科运营着一个数据要素流通平台,汇聚了大量公共数据与市场化数据资源。平台上线后,数据有了、功能全了,但面临一个典型的"最后一公里"问题:用户找数靠关键词硬搜,用数靠自己摸索,运营团队想收集用户需求却缺乏系统化手段——三大断层(找数难、用数难、运营难)导致平台价值没有充分释放。 龙石数据为平台部署了AI用数智能体,构建了"感知-匹配-演进"三位一体的智能入口。在技术层面,基于语义检索和模糊检索双模引擎理解用户的自然语言查询意图,自动引导用户从查找数据到申请使用的全流程。运营层面是这次部署中更值得关注的亮点——智能体持续分析用户的搜索失败记录和浏览行为中断点,自动识别潜在的数据需求并生成需求洞察报告,这些洞察直接驱动了数据产品的上架、优化和迭代,形成了"需求驱动供给"的良性循环。 上线后的效果从两个维度得到验证。效率维度:平台基础咨询工单量显著下降,用户从提出问题到获取数据的耗时大幅缩短。价值维度:系统持续挖掘出多个真实用户需求,其中部分高价值需求已进入产品开发流程,数据产品的复用率明显提升。运营团队的反馈很直白:"以前推数据产品像蒙着眼睛打靶,智能体给了我们一杆瞄准镜。"这个案例的启示在于:AI用数的价值不仅是降低查询门槛,更在于打通了从"用户要什么"到"平台供给什么"的需求驱动链路。 九、常见问题(FAQ) Q1:AI用数的准确率到底能达到多少?是不是和通用ChatGPT差不多? AI用数的准确率取决于两个变量:数据治理的质量和问题本身的复杂度。简单场景(如按条件查询、单表统计、排名排序等),准确率可以做到接近100%;复杂场景(跨多表关联推理、涉及模糊业务概念的查询)会有一定误差。关键区别在于:企业AI用数不是开放域问答,而是在企业自身数据资产范围内做查询和分析——治理到位的元数据和数据标准,能大幅缩小AI的理解偏差。通用的ChatGPT不了解你企业的数据结构和业务口径,而企业AI用数的上下文由你自己的数据知识库定义,两套系统的性质不同,不宜直接类比。 Q2:我们公司用的是Oracle/SQL Server,不是MySQL,能用吗? 可以。AI用数智能体适配MySQL、达梦、Oracle、SQL Server等多类主流数据源,底层数据库类型不影响自然语言查询能力。在提示词模板的SQL约束规范中,将语法类型设置为与你实际使用的数据库对应的方言即可。如果企业同时使用多种数据库,可为不同场景分别配置对应的SQL语法约束。 Q3:数据不出域怎么保证?如果是私有化部署,大模型放在哪? 龙石AI用数智能体支持客户自备本地大模型(如DeepSeek或千问3),所有数据查询和推理分析在本地服务器上完成,企业数据不出域、不上云。大模型部署在客户自有服务器上,数据流转的全链路控制在企业内部网络范围内,符合数据安全合规要求。 Q4:我们的数据资产目录还没建全,能不能先用起来? 不需要等"完美"再启动。建议的策略是:先选定一个业务价值最高的用数场景(比如销售数据查询),把这个场景相关的几张核心表的元数据做扎实,配置好提示词和预设问题,先跑通再横向扩展。反过来看,AI用数的需求本身也会驱动数据治理的加速——当你发现某张表查询结果不可信时,自然会推动它的数据标准和质量管理。治理和用数可以并行推进、相互促进,而不是先做完一个再做另一个。 Q5:业务人员问的问题太口语化怎么办?比如"最近卖得怎么样"这种模糊问题。 这正是混合检索引擎发挥作用的地方。AI用数智能体的语义检索和模糊检索双模引擎能够理解"卖得怎么样"背后用户可能想查询的是销售额、增长趋势、完成率等指标。同时,预设问题功能把最高频的业务问题提前配置为标准查询,确保模糊问法也能命中准确结果。配合问题推荐功能——系统根据当前提问自动推送相关的待探索问题——引导用户逐步聚焦分析方向,让模糊的查询意图在交互过程中逐步明确。 Q6:多个部门使用同一个场景,怎么控制数据权限? 通过智能体权限管理,可以按角色进行数据库、表、字段三个级别的精细化权限控制。例如,销售一部只能看到华东区的客户和订单数据,销售二部只能看到华南区的数据,销售总监可以看到全部区域的数据。权限分配遵循最小化原则——每个用户只能查询被授权的数据范围,从机制层面杜绝越权访问。 Q7:AI给的结果万一错了,业务人员怎么判断? 这恰恰是数据解读和元数据标注的价值所在。AI返回结果时附带三层辅助判断信息:第一,文字解读——提炼数据的关键特征,便于用户快速理解结果含义和发现异常;第二,数据来源说明——标注数据取自哪个系统、哪个表,让用户知道结果的数据基础;第三,工单反馈机制——用户对结果不满意可一键提交反馈工单,运营人员复核处理后反馈修正结果。这三层机制共同构成了"可信用数"的保障体系,让用户在使用AI结果时有据可查、有错可纠。 十、方法论收尾 AI智能用数本质上是"理、采、存、管、用"五阶方法论中"用"这一环的自然延伸。它不是一个独立的新系统或新项目,而是数据治理水到渠成之后的能力升级。 值得强调的是:不是"等治理做完美了再上AI用数",而是AI用数的需求反过来会推动"理"和"管"两个环节的加速。当业务人员用自然语言问数据问不准的时候,自然会暴露出数据标准不一致、元数据标注缺失、数据质量有问题——这些问题的根因和解决路径,都在"理采存管用"的前四环里。AI用数就像一面镜子,把治理层面的问题照得一清二楚。 对于已经按照"理采存管用"方法论推进数据治理的企业来说,AI用数不是另起炉灶的新投入,而是已有建设成果的价值释放。工具到位了、数据治理了、业务人员能自己查数据了——这才是数据中台建设的最终目的:让数据不仅是技术团队管理的资产,更是业务人员能用起来的工具。 参考来源: Data-Centric AI, Andrew Ng et al. DCMM 2.0 数据管理能力成熟度模型(GB/T 36073-2025) DAMA-DMBOK 2.0 数据管理知识体系指南, DAMA International ArXiv 2402.05211, "Data Catalogs as a Gateway to Data Assetization"
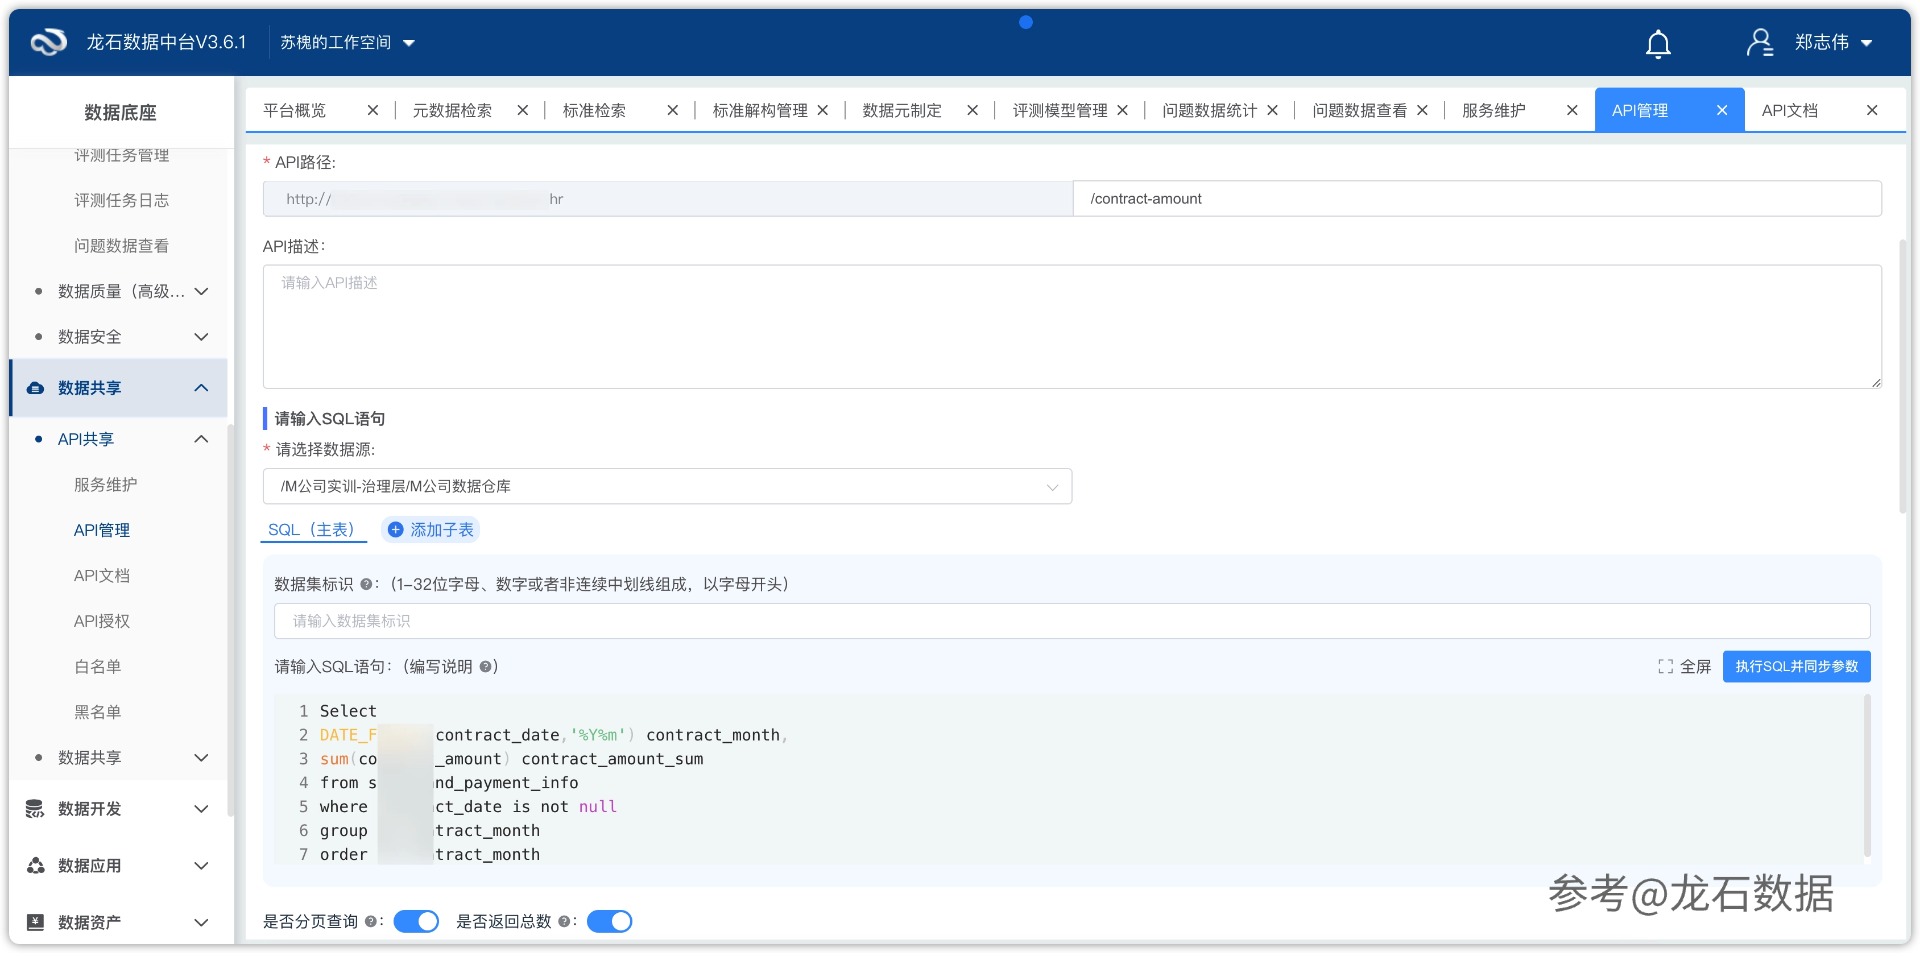
第一章 场景——数据就在那儿,但用不了 周二上午十点,运营部门的小王在企业微信上发来一条消息:"张工,我们这周要做客户复购率分析,需要客户订单表、商品信息表和会员积分表,字段清单我发你。"附件里列了三十多个字段,横跨CRM(客户关系管理)系统、ERP(企业资源计划)系统和营销活动平台三个独立数据库。张工看了一眼消息,心里默默列了一下工作清单:先确认这三个系统的数据库只读账号还在不在、分别登录查询表结构和字段名是否匹配、找开发排期写一个RESTful API(表述性状态传递接口)服务把数据整合出来、配一套鉴权机制防止未授权访问、再写一份接口文档给小王对接——这套流程走下来,保守估计两天。而小王那边,复购率分析的报告周五就要交。 这个场景在多数企业的IT部门几乎每天都在上演。数据治理的前几步——梳理数据资源、采集汇聚、建仓存储、质量管控——都在推进,但到了最后"用出去"这一步,往往卡在了一个手工开发的瓶颈上。让业务部门直接连数据库是不现实的(安全风险和权限管控都不可控),把数据导出成Excel文件传递又丧失了实时性和可追溯性,而走正规的API开发流程,开发和测试周期又太长。API(应用程序编程接口,Application Programming Interface)是当下最灵活的跨系统数据共享方式,因为调用方不需要知道底层数据库的结构,只需要按约定好的请求格式发送一个HTTP请求就能获取数据,数据库账号密码完全不暴露。但手工开发API意味着每个数据共享需求都要经历"需求评审→代码开发→安全审计→接口文档→联调测试"的完整软件工程流程,效率低、安全控制靠人工保障容易遗漏。 龙石数据中台的数据共享模块在设计上正是针对这一瓶颈。它对应"理、采、存、管、用"五阶方法论中"用(促共享重应用)"阶段的核心能力——选择数据源后通过可视化界面编写SQL(结构化查询语言,Structured Query Language,一种用于管理和查询关系型数据库的标准编程语言)生成API,再通过鉴权(身份验证,验证调用者是否具备合法的访问凭证)、IP白名单(来源限制,仅允许指定IP地址的请求通过)、流量控制(调用量限制,约束同一时间的并发数和单日的总调用次数)三道防线保障访问安全,整个配置过程不需要写一行代码。 第二章 前置条件——API发布前要准备好什么 在开始一键发布API之前,需要完成以下两个前置准备,确保配置过程顺畅无阻。 一、共享库(DS层)数据源已接入 确认数据源接入中,共享库的数据源已配置并连接正常。数据中台采用五层分层架构对数据进行递进式治理:来源库(SRC,Source)直接从业务系统接入原始数据;贴源库(ODS,Operational Data Store)保存与源系统结构一致的镜像数据;治理库(DW,Data Warehouse)完成数据清洗、标准化和模型设计;应用库(ADS,Application Data Store)存放面向具体业务场景的汇总结果数据;共享库(DS,Data Sharing)是数据中台对外提供数据共享服务的统一出口。自助API默认从共享库DS层读取数据对外提供服务,因为DS层的数据已经过了完整的数据质量校验和标准化处理,是数据治理后的"成品"数据。但不仅限于DS层——根据实际业务需要,也可以选择治理库DW层(需要标准化但无需对外统一出口的数据)或应用库ADS层(面向具体业务场景的汇总数据)作为API的数据源。检查路径为「数据集成→数据源接入」,确认所需数据源的连接状态为"正常"。 二、了解目标数据表结构 明确要共享的表名、字段清单,以及哪些字段需要脱敏处理(如身份证号、手机号、银行卡号等个人敏感信息)。自助API在配置SQL时支持主子表嵌套返回——主查询返回主表数据,子查询返回关联的子表数据,最终以嵌套JSON结构输出。同时平台提供字段转换规则引擎,支持值映射(如将代码值"F"转换为"女")、日期格式化、正则表达式、默认值填充以及字符串脱敏等多种后处理能力。提前梳理好敏感字段清单,可以在后续第三步"转换规则设置"中一次性完成配置,避免API上线后发现数据脱敏遗漏再回退修改。 关键配置前置条件速查 前置条件 确认位置 说明 共享库数据源已接入 数据集成→数据源接入 共享库DS数据源连接正常 了解表结构和敏感字段 数据治理→元数据管理 明确哪些字段需脱敏处理 第三章 操作步骤一——创建API服务与自助API 3.1 创建API服务 第一步是创建一个API服务。API服务是多个API的逻辑分组容器,你可以把它理解为一个"服务文件夹"——同一个业务域下的多个API(如客户域下的客户信息查询、订单查询、积分查询等)统一归属到一个API服务下进行管理。进入「数据共享→API共享→服务维护」,点击"新增服务"按钮打开创建窗口。 在创建窗口中需要填写两个名称:服务名称(英文,如customer)和服务显示名称(中文,如"客户数据服务")。服务名称会作为API访问地址的前缀——假设数据中台部署在http://192.168.1.100:8080,服务名称为customer,则该服务下所有API的访问地址都以http://192.168.1.100:8080/customer/开头。服务名称要求全平台唯一,建议按业务域命名,字母开头、长度控制在32位以内。服务显示名称仅用于运维人员在管理界面中识别,对调用方不可见。 创建服务的同时即可配置流控管理,这是访问控制的第一道防线。流控包含两个核心指标:并发数(同一时刻系统正在处理的请求数量上限,数值范围1-9999,不填写则无限制)和日最大访问量(一天内系统处理的总请求数上限,数值范围1-9999,不填写则无限制)。这两个指标分别从"瞬间冲击"和"持续消耗"两个维度保护后端数据库。配置完成后点击"上线"按钮使服务生效——注意,创建服务不等于服务上线,服务上线后该服务下的API才可被调用;服务下线后该服务下所有API均不可调用,再次上线后立即恢复(配置和授权关系均不会丢失)。 API服务维护配置表 配置项 填写内容 说明 服务名称 英文,如customer 作为API访问地址前缀,字母开头,长度1-32位 服务显示名称 中文,如"客户数据服务" 管理界面识别用,调用方不可见 并发数 1-9999(不填视为无限制) 服务级并发数上限,控制同一时刻的并发请求量 日最大访问量 1-9999(不填视为无限制) 服务级日调用总量上限,控制单日总请求数 3.2 新增自助API 创建好API服务后,下一步是新建具体的API。进入「数据共享→API共享→API管理」,点击"新增自助API"。自助API(Self-Service API)是通过自定义SQL语句直接从数据库查询数据并返回结果的API,属于零代码开发模式——配置者只需编写SQL和设置基本参数,平台自动生成完整的RESTful接口,省去了传统开发中"写Controller→写Service→写DAO→写测试用例"的全部编码工作。目前平台支持的数据库类型包括MySQL、Oracle、SQLServer、PostgreSQL、DM8(达梦数据库)、Doris(Apache Doris分析型数据库)以及Vastbase_G100(海量数据库)等主流数据库。 自助API采用六步引导式配置流程,下面逐一说明。 第一步:设置API基本信息 配置项 填写说明 API名称 自定义API名称(中文),如"客户订单查询接口",便于管理识别 请求方法 GET(查询类接口)/ POST(提交数据或复杂查询场景) 请求类型 GET方法无需设置;POST方法可选application/json等格式 鉴权模式 签名模式(HMAC-SHA1动态签名)/ 简易模式(仅校验AppKey)/ 不鉴权(详见第四章) API路径 URL访问路径,全平台唯一,如/customer/order/query API描述 API用途说明,便于调用方理解接口功能 第二步:配置查询SQL语句 选择数据源(推荐选择已接入的共享库DS层数据源,也可根据业务需要选择治理库DW层或应用库ADS层,检查路径:「数据集成→数据源接入」),然后编写SQL语句。SQL中可以使用${参数名}占位符来引用查询参数——当调用方发起API请求时,URL中传递的参数值会自动填入SQL占位符位置。例如SQL语句写为SELECT * FROM customer_order WHERE customer_id = ${customerId},调用方请求/customer/order/query?customerId=12345时,实际执行的SQL会替换为SELECT * FROM customer_order WHERE customer_id = '12345'。编写完SQL后点击"执行SQL"按钮,系统会自动识别SQL中的参数占位符并展示在"输入参数"和"返回参数"区域中,参数的类型和示例值由系统根据数据库元数据自动推断。 自助API支持主子表嵌套返回的高级特性。主表查询和子表查询通过"数据集标识"进行关联:主表设置一个英文标识(如student),子表在查询参数中引用主表的数据集标识作为前缀(如${student.no}),平台会自动按关联键组织嵌套JSON结构。以学生信息系统为例,主表student_info查询学生基本信息,数据集标识设为student,SQL为select * from student_info where no = ${no};子表student_profiles查询学生各科成绩,数据集标识设为score,SQL为select * from student_profiles where no = ${student.no}——返回结果会以如下嵌套JSON结构呈现: { "student": { "no": "2024001", "name": "张三", "class": "计算机科学2024级" }, "score": [ {"no": "2024001", "subject": "数据结构", "score": 92}, {"no": "2024001", "subject": "操作系统", "score": 88} ] } 第三步:转换规则设置 在返回参数列表中,对敏感字段或需要格式化的字段点击"添加规则"按钮。平台内置的转换规则类型包括:值映射(将代码值转换为可读中文,如性别字段F→女、M→男)、剪切字符串、日期格式化(如将时间戳1700000000转换为2023-11-15)、正则表达式提取、默认值填充(当字段值为空时自动填入默认值)、字符串补齐、字符串脱敏以及自定义脚本等。 脱敏(Data Masking,数据遮蔽)是共享场景下使用频率最高的转换规则。以身份证号脱敏为例:选择"字符串脱敏"规则,设置开始位置为4、结束位置为14、替换内容为*,则原始值320102199001011234经规则处理后输出为320**********1234——出生日期信息被遮蔽,但仍保留了地区码和校验位供必要时进行区域统计或格式校验。 第四步:测试API 填写输入参数的测试值,点击测试按钮,系统将在右侧展示完整的请求URL、响应状态码和返回数据结果。测试环节需要重点验证三个方面:SQL逻辑是否正确(返回的数据是否符合预期筛选条件)、参数映射是否准确(入参值是否被正确替换到SQL中)、转换规则是否生效(脱敏字段和格式化字段输出是否符合规则设定)。 第五步:流量控制 为该API单独设置并发数和日最大访问量。API级流控的优先级高于服务级流控——当API级流控设置了独立阈值时,该API以API级阈值为准,不受服务级阈值约束;当API级未设置时,继承服务级流控配置。建议对核心业务API(如订单查询、支付状态查询)单独设置更严格的API级流控,保证关键业务的资源独占;对辅助性API(如字典查询、配置查询)可以复用服务级的默认流控阈值。不填写代表无限制,生产环境建议两项均设置合理阈值。 第六步:下载API文档 配置完成后,平台自动生成一份完整的API接口文档,内容包括请求方法(GET/POST)、请求类型(Content-Type)、鉴权模式、输入参数清单(参数名、类型、是否必填、示例值)、返回参数清单(字段名、类型、说明)、返回示例(JSON格式的样例数据)。调用方无需人工沟通,参考文档即可完成对接开发,大幅降低跨团队的沟通成本。 自助API六步配置速查 步骤 操作 关键配置 说明 第一步 API基本信息 API名称、请求方法、鉴权模式 GET用于查询,POST用于提交或复杂查询 第二步 查询SQL 数据源、SQL语句、数据集标识 支持${}参数占位符和主子表嵌套 第三步 转换规则 脱敏、值映射、日期格式化 对敏感字段和格式化字段添加规则 第四步 测试API 测试参数值 验证SQL逻辑、参数映射、转换规则 第五步 流量控制 并发数、日最大访问量 API级流控优先级高于服务级 第六步 下载文档 自动生成 含请求/返回参数和样例数据 3.3 了解其他API类型(背景补充) 除了自助API之外,龙石数据中台还提供了两种辅助型API类型,用于覆盖"已有API纳管"和"复杂流程编排"两类场景。 穿透API(Proxy API):企业往往已经有一些现成的第三方API在运行,这些API分散在不同的系统中,管理起来很不方便。穿透API的作用是把已有的第三方API注册到数据中台统一纳管——不需要修改原API的任何代码逻辑,平台作为代理层实现地址转换(调用方访问平台统一地址,平台透明转发到真实API地址)、统一鉴权(在平台层叠加鉴权策略)、调用日志(自动记录每次调用的请求和响应详情)。新增穿透API时,请求方法、请求类型、鉴权模式、代理地址等参数必须与原API完全一致,否则代理转发会失败。 编排API(Orchestration API):当单个自助API无法满足需求时——比如需要一次请求同时调用多个数据源的接口并融合返回结果,或者需要按条件分支执行不同的API调用链——编排API提供了拖拽式可视化画布来组装复杂的API流程。编排组件库包括:Restful API调用、WebService(一种基于SOAP协议的网络服务接口标准)调用、数据库表查询/输出/更新、JSON/XML报文互转、条件判断、流程分支以及Java自定义逻辑等。编排API适用于跨系统数据聚合、主子表跨多库的事务性保存、跨系统业务流程触发等复杂场景。举例来说,一个"创建订单"的编排API可以在一次请求中同时完成在订单库插入订单记录、在库存库扣减库存、在用户库检查并更新用户等级——三个数据库操作要么全部成功、要么全部回滚,保证数据一致性。 第四章 操作步骤二——配置访问控制策略 访问控制是API共享安全的基石。龙石数据中台提供三道防线构成纵深防护体系:鉴权(验证调用者身份——"你是谁")→ IP白名单/黑名单(控制访问来源——"从哪来")→ 流量控制(限制调用频次——"用多少")。三道防线既可以独立使用也可以灵活组合,适配从公开数据到敏感交易数据的不同安全等级需求。 4.1 第一道防线:API鉴权——验证"你是谁" 鉴权(Authentication,身份认证)回答的是"谁在调用这个API"的问题。进入「数据共享→API共享→API授权」,平台采用统一的AppKey + SecretKey(应用密钥对)授权模式:系统为每个调用者自动生成一对唯一的AppKey(应用标识)和配对的SecretKey(应用密钥),AppKey作为调用者的身份标识在API请求中传递,SecretKey由调用方妥善保管用于生成请求签名,不通过网络传输。 平台提供三种鉴权模式,在新增或编辑API时选择: 鉴权模式 技术原理 适用场景 安全等级 签名模式 使用HMAC-SHA1(基于哈希的消息认证码算法,Hash-based Message Authentication Code with SHA-1)对请求参数动态生成签名摘要。每次请求的签名都不同(因为包含了时间戳和随机数),可有效防止重放攻击——攻击者截获一个请求后无法直接重复使用,因为过期的签名会被服务端拒绝 交易数据、个人敏感信息(如身份证号、手机号、银行卡号)、财务数据等 ★★★ 简易模式 仅校验请求中携带的AppKey是否在平台中存在且处于有效状态,不校验请求参数是否被篡改 内部系统之间的非敏感数据查询、低频调用场景 ★★☆ 不鉴权 不采取任何身份验证措施,任何人知道API的完整URL地址即可发起调用 公开数据(如天气、节假日信息)、测试环境调试阶段 ★☆☆ 配置建议:涉及用户个人信息的API必须使用签名模式;内部系统间的非敏感数据查询(如部门列表、组织架构)可使用简易模式降低对接复杂度;测试阶段的API可临时选择不鉴权,但务必同时开启白名单将访问来源限定在测试服务器的IP范围。API上线后可以随时修改鉴权模式——服务下线→修改鉴权模式→重新上线即可生效,已有的授权关系不丢失。 4.2 第二道防线:IP白名单/黑名单——控制"从哪来" 进入「数据共享→API共享→白名单 / 黑名单」。白名单和黑名单从网络层面对调用来源进行准入控制,是鉴权的有效补充——鉴权回答"你是谁",白名单/黑名单回答"请求从哪个网络地址来的"。 白名单(Allowlist):开启后,仅允许白名单列表中列出的IP地址发起请求,不在白名单内的IP一律被拒绝访问。白名单的防护逻辑是"默认全部拒绝,只放行已知IP"——这是一种最小权限原则的实践。在配置白名单时需要注意:如果API前面有负载均衡器(如Nginx、F5等)、API网关或反向代理,务必把网关/代理服务器的出口IP也加入白名单,否则经过网关转发的请求虽然来自合法调用方,但因为到达平台的IP是网关IP而非原始调用方IP,会被白名单拦截。 黑名单(Blocklist):将非法或异常的IP加入黑名单后,来自该IP的所有调用请求将被直接拒绝。黑名单的典型使用场景是动态防御——当监控到某个IP在短时间内发起大量鉴权失败请求(疑似暴力破解AppKey)、或某个IP的请求量异常飙升(疑似爬虫或攻击脚本),将该IP加入黑名单快速阻断攻击。黑名单的作用与白名单互补:白名单做"准入控制",黑名单做"攻击响应"。 组合策略建议:推荐采用"白名单为主、黑名单为辅"的配置策略。先通过白名单将API的访问来源精确限定在已知的业务系统IP和网关IP范围内,再通过黑名单动态封禁来自这些已知IP中出现的异常调用行为。两者叠加使用可以同时覆盖"防止未知来源访问"和"已知来源中的异常行为处置"两个安全维度。 4.3 第三道防线:流量控制——限定"用多少" 流量控制(Rate Limiting,速率限制)从调用频次维度保护后端服务的稳定性。流量控制分两个层级: 层级 控制指标 配置位置 粒度说明 服务级流控 并发数 + 日最大访问量 API服务维护 → 流控管理 整个服务下所有API共享配额 API级流控 并发数 + 日最大访问量 新增/编辑API → 流量控制 单个API的独立配额 并发数控制的是"同一时刻系统正在处理的请求数量上限",它的防护目标是瞬间流量洪峰——比如某个业务系统在整点批量触发了几百个API调用,并发数限制确保同时进入数据库的请求不会超过后端数据库的连接池容量。日最大访问量控制的是"一天内系统处理的总请求数上限",它的防护目标是持续低频但高总量的异常调用——比如某个调用脚本因为代码Bug写成了死循环,以每秒1个请求的速度低调运行,并发数永远不会触发,但持续24小时就是86400个请求,日最大访问量可以在总量层面拦住这种"温水煮青蛙"式的消耗。 两个指标从不同维度保护系统,建议在生产环境中同时设置合理的阈值。优先为交易类API(下单、支付等直接关联业务结果的接口)设置较低的日最大访问量,为查询类API(数据列表、统计报表等只读接口)设置较高的日最大访问量或复用服务级默认值。不填写代表无限制,仅建议在测试环境或内部工具类API中使用。 三道防线配置速查 防线 机制 解决的问题 配置路径 关键操作 第一道 鉴权(AppKey + SecretKey) 验证调用者身份合法性 API共享→API授权 创建AppKey/SecretKey,选择鉴权模式 第二道 白名单/黑名单 控制请求来源IP范围 API共享→白名单/黑名单 添加/删除IP地址,开启/关闭开关 第三道 流量控制(并发数+日最大访问量) 限制调用频次 服务维护/API管理 设置服务级和API级阈值 第五章 验证结果——发布后的监控与调用 5.1 调用测试 API发布并上线后,可以通过三种方式进行调用测试。第一种是使用平台内置的测试功能——在API管理列表中找到目标API,点击"测试"按钮,输入参数值后直接查看返回结果,这是快速验证最便捷的方式。第二种是使用Postman——一款流行的API调试工具——将平台生成的API文档中的请求地址、请求方法和参数填入,发送请求验证。第三种是在命令行中使用cURL工具发起HTTP请求验证,适合自动化测试脚本集成。 以下是一个典型的cURL调用示例(以签名模式为例,签名参数由平台提供的SDK工具包自动计算生成): curl -X GET "http://192.168.1.100:8080/customer/order/query?customerId=12345" \ -H "AppKey: your_app_key_value" \ -H "Timestamp: 1719654321" \ -H "Signature: (由HMAC-SHA1算法计算生成的签名值)" 验证时需要重点检查三个方面:返回数据的字段完整性(所有预期字段是否都出现在返回结果中)、数据准确性(查询条件和返回值的对应关系是否正确)、脱敏效果(敏感字段的输出是否符合脱敏规则设定)。如果发现SQL逻辑有问题,可以直接编辑API修改SQL后重新测试,无需像传统开发流程那样走"改代码→部署→重启服务"的流程。 5.2 调用分析——三维度监控 进入「数据共享→API共享」,平台从三个维度提供API调用数据的可视化监控分析,帮助运维人员实时掌握API的使用情况: 分析维度 入口 展示内容 服务维度 API服务调用分析 每个API服务的每日调用量(成功次数/失败次数分别统计)、历史调用总量、今日实时调用量、日调用量趋势折线图 用户维度 API用户调用分析 每个AppKey调用者的今日调用量(成功/失败数)、历史调用总量、日调用量趋势——用于识别哪个调用方的用量异常增长 API维度 API调用分析 每个API的今日调用量(成功/失败次数)、历史调用总量、日调用量趋势——用于定位哪个API是热点接口 三个维度的分析互相补充:服务维度的趋势图帮你发现某个业务域的调用量是否在持续增长(需要扩容),用户维度帮你发现某个调用方的调用行为是否异常(如某个AppKey的失败率突然从2%飙升到40%,说明该调用方可能对接有问题),API维度帮你发现哪些API被调用最频繁(可能需要做缓存优化或SQL调优)。 5.3 API质量监控 除调用量统计外,平台还提供"API集监控"功能用于持续的API质量检测。将需要监控的多个API加入一个测试集后,配置以下三种监测规则: 可用性监测:定期向API发送测试请求,检查响应状态码是否为200(HTTP协议中的成功响应代码),判断API服务是否正常运行。 正确性监测:检查响应报文(HTTP响应正文)中是否包含预期的关键内容——例如在返回JSON中验证是否包含"code":"success"字段——确保API不只"能通",而是"通得对"。 响应时间监测:检测API的响应耗时是否在设定的毫秒阈值内,超出阈值即判定为性能异常。 当任一监测规则触发异常时,平台自动通过微信、短信、邮件三种渠道向指定联系人发送告警通知,告警信息中附带异常原因的初步诊断(例如"响应超时,耗时3200ms,超过阈值2000ms"、"返回状态码500,疑似后端数据库连接失败"),帮助运维人员快速定位问题根因。 第六章 配置速查模板 本章将全文分散在各章节中的配置项整合为一张速查表,方便读者在实际操作时对照参考。 配置维度 配置项 填写内容 说明 服务维护 服务名称 英文,如customer 作为API地址前缀,字母开头,长度1-32位 服务显示名称 中文,如"客户数据服务" 管理界面识别用,调用方不可见 并发数 1-9999 服务级并发数上限,不填无限制 日最大访问量 1-9999 服务级日调用总量上限,不填无限制 自助API基本信息 请求方法 GET / POST 查询用GET,提交或复杂查询用POST 鉴权模式 签名/简易/不鉴权 敏感数据用签名,内部用简易,测试用不鉴权+白名单 数据源 共享库DS/治理库DW/应用库ADS 推荐选DS层,也可按需选DW或ADS层 SQL语句 SELECT ... WHERE field = ${param} 支持${}占位符绑定查询参数 最大返回记录数 正整数,如10000 防止单次查询返回数据过多导致内存溢出 数据集标识 字母开头,如student 主子表嵌套时主表标识,子表引用${主表标识.字段} 转换规则 脱敏 位置(开始/结束)+替换内容 身份证:位置4-14,替换为* 值映射 原始值→目标值 如F→女、M→男 日期格式化 格式字符串 如yyyy-MM-dd 默认值填充 默认内容 字段值为空时自动填入 流控(服务级+API级) 并发数 1-9999 同一时刻正在处理的请求数上限 日最大访问量 1-9999 一天内总请求数上限 访问控制 白名单 IP地址列表 仅允许白名单IP访问(开启后生效) 黑名单 IP地址列表 拒绝黑名单IP访问 API授权 AppKey / SecretKey 系统自动生成 每个调用方分配一对,AppKey用于身份标识,SecretKey用于签名 第七章 避坑指南与方法论收尾 7.1 避坑指南 坑一:测试时选"不鉴权",上线后忘记切回签名模式 在测试阶段,很多操作人员为了让调试过程更顺畅,选择了"不鉴权"模式,测试通过后填写上线检查清单时漏了"鉴权模式确认"这一项,直接把API发布上线。结果API在公网环境中没有任何身份验证措施,任何人知道了API地址就能直接通过浏览器或脚本拉取数据。这种情况的严重性取决于数据敏感度——如果是公开的天气数据还好说,如果是客户订单数据或个人敏感信息,后果就是数据泄露。正确的做法是:从新建API的时候就明确安全等级策略并立即选择对应的鉴权模式。测试环境如需降低鉴权门槛,可以用"简易模式+白名单限制测试IP"的组合替代裸奔的"不鉴权"模式。如果确实需要在测试阶段用"不鉴权",务必在测试完成后的上线检查清单中把"切换鉴权模式"作为必检项。 坑二:流控只配了并发数,没配日最大访问量 并发数和日最大访问量是对应两种不同攻击形态的防护指标,不能互相替代。并发数挡的是"洪峰型"攻击——攻击者在极短时间内发起大量并发请求,希望打满数据库连接池让服务瘫痪。日最大访问量挡的是"渗透型"消耗——攻击者或Bug脚本用不高不低的频率持续请求,比如每秒1次,看上去很温和,但24小时不间断就是86400次调用,如果单次返回数据1MB,一天就被拖走近10GB数据。很多运维人员觉得"我设置了并发数就够了",实际上并发数对这种"低速持久"行为完全没有反应——每次只有1个并发,远低于阈值。两项指标缺一不可,生产环境务必两项都设置。 坑三:白名单配了业务服务器的IP,忘了加API网关的IP 白名单开启后,白名单列表中的IP是唯一被允许发起请求的地址。如果API是通过API网关或反向代理(如Nginx、Kong、Zuul)对外暴露的,实际到达数据中台的TCP连接源IP是网关服务器的IP,而不是原始调用方业务服务器的IP。很多运维人员在配置白名单时只加了业务服务器的IP,结果网关代理过来的请求全部被拦截——从网关那边看请求超时,从数据中台这边看白名单拒绝日志里全是网关IP的拦截记录。排查的时候经常要来回对日志对齐时间戳才能发现是白名单漏配了网关IP。正确做法:在配置白名单时,把API调用链上所有中间节点的出口IP都列进去——包括业务服务器IP、网关服务器IP、负载均衡器IP等。 7.2 小反转——从"开发两天"到"配置十分钟" 回到第一章开头的那个场景。张工在没有数据中台之前,每次对外共享一个数据接口,需要经过"确认数据源→找开发排期→写Controller/Service/DAO代码→配鉴权机制→写接口文档→联调测试→部署上线"的全流程,按最顺利的情况估算也要两天。现在借助龙石数据中台的数据共享模块,流程简化为"进入资产目录→找到目标表→新建自助API→编写SQL语句→选择鉴权模式→开启白名单→设置流控→测试发布",八个步骤全程在可视化界面中完成,不需要写一行代码,全流程稳定控制在十分钟以内。而且这不仅是一次性的效率提升——后续的调用量统计、调用方管理、质量监控、异常告警全部由平台自动运转,张工不再需要被动地等业务部门来问"接口能不能用""为什么返回慢了""这个月调了多少次",所有数据在监控面板上一目了然。从"有人找才响应"变成了"系统自动管",这才是数据共享模块解决的核心问题——不只是省了两天开发时间,而是把数据共享这件事从"项目制的手工作坊"变成了"平台化的标准流水线"。 7.3 方法论收尾 龙石数据中台遵循"理、采、存、管、用"五阶方法论。前四个阶段——"理"清数据战略与业务方向、"采"集汇聚多源异构数据、"存"入分层模型的数据仓库、"管"控数据质量与标准规范——所有的投入和建设,最终都要在"用"这一阶段兑现业务价值。API共享模块正是"用"阶段的核心能力载体之一:它不是在简单地"把数据扔出去",而是在"服务维护→鉴权授权→黑白名单访问控制→双层流量管控→多维度调用分析→持续质量监控"的一整套机制框架下,实现数据在"用得出去"和"管得住、看得清"之间取得平衡。 在江苏某数据局的共享交换平台中,全市百余个政务节点、近4万个交换任务、千余个API服务稳定运行,库表交换量累计近千亿条,API实时交换支撑跨省通办业务实现毫秒级数据核验;在某211大学的智慧校园项目中,基于数据中台搭建的数据超市上线后,跨部门数据申请从以往的"天/周级"线下审批模式缩短到"分钟级"在线自助获取,人力处、学生处、教务处等数十个部门的数据共享效率显著提升。这些案例背后验证的核心逻辑是:数据共享的价值不在于"技术有多复杂",而在于"访问有多简单、管控有多精细"。让数据在安全可控的前提下高效流动,才是数据中台建设的最终目的。 FAQ 1. 三种鉴权模式怎么选?签名模式、简易模式、不鉴权各自适用什么场景? 签名模式基于HMAC-SHA1算法对每次请求参数动态生成签名摘要,每次请求签名不同,可有效防止重放攻击(攻击者截获一次合法请求后不能直接重复使用),适用于交易数据、财务数据、个人信息等敏感场景。简易模式仅校验AppKey是否存在且有效,不验证请求内容是否被篡改,对接复杂度低但安全等级居中,适用于内部系统之间的非敏感数据查询或低频调用。不鉴权不采取任何身份验证措施,适用于公开数据或测试环境,但必须同时开启白名单保护以限制访问来源范围。三种模式可由调用场景的数据敏感度和网络环境综合决定。 2. 白名单和鉴权能同时开启吗?不鉴权的API开启白名单后安全吗? 可以同时开启。鉴权验证"调用者是谁"(身份认证),白名单验证"请求从哪来"(来源限制),两者是互补的安全维度,不存在互斥关系。同时开启时,请求必须同时满足"AppKey合法(或签名验证通过)"和"来源IP在白名单内"两个条件才能通过。不鉴权的API开启白名单后,虽然不验证调用者身份,但只有白名单中的IP才能发起请求——适合完全信任的内网环境(内网IP本身就是一种身份背书)或对外提供只读公开数据的场景。 3. 并发数和日最大访问量分别控制什么?不填写代表什么? 并发数控制同一时刻系统正在处理的请求数量上限,防护目标是瞬间流量洪峰(如定时任务批量触发调用)。日最大访问量控制一天内系统处理的总请求数上限,防护目标是持续低频但高总量的异常调用(如脚本Bug导致的长时间循环调用)。两个指标从瞬间峰值和持续总量两个维度互补防护,不能互相替代。不填写代表无限制,建议生产环境两项均设置合理阈值。 4. 自助API和穿透API有什么区别?什么时候用哪个? 自助API是通过自定义SQL从数据库直接查询数据生成全新的API,属于零代码新建模式,API的逻辑在数据中台内部运行。穿透API是将已有的第三方API注册到数据中台统一纳管,不改原API逻辑,平台作为代理层提供地址转换、统一鉴权、调用日志等附加能力。如果数据存储在龙石数据中台的共享库中,用自助API直接在平台上创建;如果已有现成的外部API需要统一管理、监控和鉴权,用穿透API纳管。 5. API服务下线后已有的调用方会怎样?重新上线能恢复吗? 服务下线后,该服务下所有API将立即停止响应,调用方会收到HTTP连接失败或超时错误(具体取决于网关配置)。再次点击"上线"按钮后API调用立即恢复正常——不会丢失任何配置信息,不会影响已有的AppKey/SecretKey授权关系,也不会清空调用统计历史数据。服务下线是一个可逆的管理操作,常用于维护窗口期或紧急安全处置场景。 6. 自助API支持哪些数据库类型?查的是哪个库的数据? 自助API支持MySQL、Oracle、SQLServer、PostgreSQL、DM8(达梦数据库)、Doris(Apache Doris分析型数据库)、Vastbase_G100(海量数据库)等主流数据库。查询的数据源在创建API时自由选择——推荐选择共享库DS层,因为DS层是数据中台五层架构(SRC→ODS→DW→ADS→DS)中对外提供数据共享服务的统一出口,DS层的数据已经过完整的质量校验和标准化处理。 7. 如何监控API的可用性和正确性? 进入「数据共享→API共享」中的"API集监控"功能,将需要监控的多个API加入一个测试集,配置三种监测规则:可用性监测(检查响应状态码是否为200,确保服务正常运行)、正确性监测(检查响应报文中是否包含预期关键内容,如"code":"success",确保API逻辑正常)、响应时间监测(检测响应耗时是否在设定的毫秒阈值内)。任一规则触发异常时,平台自动通过微信、短信、邮件三种渠道向指定联系人发送告警,告警信息附带异常原因便于快速定位。 8. 编排API能做什么自助API做不到的事? 编排API的核心能力是服务聚合与流程编排。它可以一次请求协调调用多个独立的自助API或外部API并融合返回结果(如同时查订单信息和用户信息合并返回),可以按条件判断走不同分支(如根据订单金额是否大于阈值决定走不同的审批流程),可以在编排画布中嵌入自定义Java逻辑处理复杂计算,可以实现跨多库的事务性操作(如订单创建同步扣减库存和更新用户积分,三个操作要么全部成功要么全部回滚)。自助API本质是"一个SQL→一个API"的一对一映射,编排API是"多个API+流程控制+事务管理→一个聚合API"的多对一编排。 本文为操作实践指南,所述操作路径和配置参数基于龙石数据中台产品公开功能。文中案例数据来自公开的项目建设成果通报及相关文献资料,供读者参考。 参考来源: DAMA International,《DAMA数据管理知识体系指南(第二版)》(DAMA-DMBOK2),机械工业出版社,2020年。 GB/T 36073-2025《数据管理能力成熟度评估模型》(DCMM 2.0),国家市场监督管理总局、国家标准化管理委员会,2025年发布。
一、一家制造企业的报表困境 某制造企业的数据工程师老张,接到老板一个看似简单的需求:"帮我出一份各事业部Q2客户合同金额Top10的报表。"数据中台已经接入了CRM(客户关系管理系统)和ERP(企业资源计划系统),网络通了,管道流量也正常,老张觉得写个SQL半小时就能交差。 结果他折腾了一下午,报表还是出不来。问题不是数据没接到,而是两个系统在说不同的"数据语言":CRM里客户名称写的是"XX科技股份有限公司",ERP里写的是"XX科技股份"——少了"有限公司"四个字,SQL的GROUP BY直接把同一个客户拆成了两条记录。CRM的合同金额是含税价,ERP里是不含税价,同一份合同两个数字,财务和销售各执一词。CRM用"A/B/C"标注客户等级,ERP用"战略/重点/普通",同一个分类维度三种写法。老张不是没数据,而是被"数据方言"困住了。 这个场景在很多建了数据中台的企业里反复出现。数据接进来了,管道的流量也正常——但如果大家说的是不同的"数据语言",中台只是一个更大的混乱仓库。 很多团队在做数据中台项目时,精力主要花在"接数据"和"跑通流程"上,数据标准管理被放在项目后期甚至直接跳过。标准不是没有——文档里有,Excel里有,共享盘里有——但它们从来没有真正进入过数据的流转链路。数据标准的制定只是序曲,真正让标准在数据流转中扎根,才是数据治理从"建完"走向"用起来"的关键一步。这个"扎根"的过程,在数据治理的专业领域有一个专门的术语,叫落标。 本文从龙石数据中台的标准模块操作入手,拆解标准配置→字段映射→质量稽核三个维度的实操路径,让标准不再是静态文档,而是数据流转中每天自动执行的规则。 二、落标到底是什么意思 在深入操作之前,有必要先厘清一个概念:什么叫"落标"。 落标,就是把文档里定义的数据标准(字段名、数据类型、值域范围、代码集),转变成数据流转中实际执行的校验规则。标准写在文档里是"纸面标准";标准挂接到物理表的字段上、在数据入库或使用环节自动校验,才算"落标"。举一个直观的对比:文档里写"性别字段取值应为男/女",这是纸面标准;平台在数据接入时自动检查gender字段是否只有M(男)/F(女)两个合法值、超出就标记为问题数据并推送给责任人,这才是落标。 从DCMM(数据管理能力成熟度模型,国家标准GB/T 36073-2025)的视角来看,情况更加清晰。DCMM在数据标准能力域中明确区分了"制定标准"和"执行标准"两个层次。很多企业卡在2级(受管理级),不是因为缺少标准文档——实际上不少企业连国标行标都整理得很齐全——而是因为标准没有进入执行链路。文档在那里,数据跑起来的时候没人去核对。DCMM的评估本质上是在问:你的标准,是在数据流转中被实际遵守的,还是只存在于制度文件里? 把这个过程拆解为三个可操作的动作: 定义:在平台中配置数据元(Data Element),即数据的基本单元,规定字段名、数据类型、值域范围、代码集等属性——对应"标准制定"模块; 挂接:把定义好的标准关联到物理表的字段上——对应"关联字典"和"字段映射"功能; 稽核:用自动化规则持续检查实际数据是否符合标准——对应"引用完整性检查"等质量稽核规则。 龙石数据中台在"理采存管用"方法论中,将"管"数据环节完整覆盖了标准落标的全部动作:标准登记(国标/行标/地标/团标/内部规范)→ 标准制定(数据元+代码集)→ 元数据管理(字段挂接)→ 质量稽核(自动化校验)。四个模块协同运转,而非各自孤立。 三、分步操作:让标准在数据中台上跑起来 以下按照真实的操作流程拆解五步。每一步均附配置表(配置项/填写内容/说明),可直接在龙石数据中台上操作执行。 3.1 第一步:标准登记——把外部标准"搬"进平台 功能位置:数据治理 → 标准登记 标准登记的职责,是将国标(GB/T)、行标、地标、团标及企业内部规范登记到数据中台,构建统一的"标准库"。这个动作把分散在不同文档、不同部门的标准集中到一个可检索、可引用的平台上,为后续的标准制定和稽核提供"原材料"。 配置表1:五类标准登记入口 标准类型 典型内容 内置分类依据 用途场景 国家标准(GB/T) GB/T 4754-2017 国民经济行业分类 ICS国际标准分类 行业分类、行政区划等通用标准 行业标准 GA/T 2000.x 公安信息代码 国家行业标准分类 特定行业垂直领域的编码规范 地方标准 省级/市级数据元标准 地方标准分类 地方政务数据的特定编码 团体标准 行业协会发布的团体规范 ICS分类 行业联盟或协会的补充标准 规范管理 企业内部现有的编码表、命名规范 按业务主题自定义分类 企业自定义的业务规则和惯用编码 操作要点:标准附件支持上传Word或PDF格式的原始文件;支持"代替已有标准"操作,用于标准版本更替场景;标准发布后才能在后续模块(标准制定、关联字典、质量稽核)中被检索和应用。 标准登记之后,真正的"消化"工作在标准解构——将标准文件中的代码集和代码项拆解为平台可识别的结构化数据。 配置表2:标准解构三种方式 方式 适用场景 操作 手工新增 少量代码项(几十条以内) 逐条添加代码值、代码名称,支持模板导入 复制 标准版本更替,大部分代码集不变 将原标准代码集复制到新标准下,再修改差异项 导入 大量代码集或代码项 下载导入模板,按模板填入多个代码集后批量导入 注意:解构后的代码集需要提交审核,审核通过后才可用于后续的数据质量稽核和数据清洗。标识符全局不可重复,否则保存时会报错。 3.2 第二步:数据元制定——定义数据的"身份证" 功能位置:数据治理 → 标准制定 → 数据元制定 数据元(Data Element)是数据的基本单元,相当于数据的"身份证"——规定了它的名字、类型、长度、可以取什么值。每一个需要标准化的数据字段,都需要通过数据元制定功能定义一套完整的属性。这些属性是后续字段映射挂接和质量稽核的依据——标准是否可执行,取决于数据元的定义是否完整。 配置表3:数据元制定的核心属性 配置项 填写内容示例 说明 数据元来源 CRM系统 / 财务部 该数据元最初产生于哪个系统或部门 数据元分类 人员类 / 机构类 / 位置类 / 金融类等 参照GB/T 19488.2-2008,共9大类。如客户姓名归入"人员类",统一社会信用代码归入"机构类" 是否核心数据元 是 / 否 唯一标识关键实体(如客户ID)、直接用于关键决策(如合同金额)、多系统共享引用(如组织机构代码)——满足其一即可标记为核心 约束类型 强制型 / 推荐型 强制型:来源系统必须遵守当前定义;推荐型:可参考执行 业务含义 "自然人在公安户籍部门登记的正式姓名" 用业务语言描述,让非技术人员也能理解这个字段代表什么 归属管理部门 人力资源部 由哪个部门负责维护该数据元的定义和解释(注意:归属部门≠来源部门) 权威系统 HR系统 对该数据元定义、创建、维护和废止负责的系统 标准属性 引用标准规范 / 自定义代码集 / 自定义规范 三选一:①引用外部标准(如GB/T 4754行业分类)②自定义一组代码值(如订单状态DRAFT/SUBMITTED/APPROVED)③自定义格式规范(如"以EH开头+6位数字") 值域范围 1-120 数据元所有可能的、有效的取值集合。如年龄不可能小于0或大于120 数据类型 字符型/数值型/日期型等11种 字符型C、数值型N、货币型Y、日期型D、日期时间型T、逻辑型L、备注型M、通用型G、双精度型B、整型I、浮点型F 数据格式 an5 / n..17,2 / an3..8 an5(aannn)表示定长5个字母数字字符前2字母后3数字;n..17,2表示最长17位小数点后2位 度量单位 CNY / m / kg / pc 为数值型数据提供无歧义的计量标准,如人民币元CNY、米m、千克kg 操作要点:制定后需发布才能生效。平台支持"相似度对比"功能——当新增数据元时,系统自动检索已存在的数据元,避免重复创建相同含义的标准定义。数据元模板设置功能允许用户自定义界面中显示哪些属性字段,适配不同项目的管理粒度要求。 3.3 第三步:代码集维护——让编码变成可读的业务语言 代码集维护是对标准解构产物的管理,也支持自定义组织内部代码集。一个代码集本质上是一组"代码值"与"代码名称"的映射表——把系统里存储的缩略代码翻译为人类可读的业务名称。 配置表4:代码集示例 标准分类 代码集名称 代码值 代码名称 来源 国家标准 性别代码 0 未知的性别 GB/T 2261.1 1 男 2 女 9 未说明的性别 国家标准 国民经济行业分类 A 农、林、牧、渔业 GB/T 4754-2017 自定义 订单状态 DRAFT 草稿 企业自定义 SUBMITTED 已提交 APPROVED 已审批 操作要点:代码集支持导出为SQL脚本和Excel文件两种格式,便于线下评审或导入其他系统。标准检索功能支持跨标准类型搜索(如在一个搜索框里同时查国标和行标),代码集检索可按标准名称或代码集名称快速定位。代码集内的代码项支持批量启用、禁用操作,用于标准迭代期间的分阶段上线。 3.4 第四步:字段映射挂接——让标准"挂"到数据字段上 这是落标的核心动作。前面的标准登记、数据元制定和代码集维护,本质上都属于"纸面标准"的准备——真正让标准和实际数据表发生关联的,是字段映射挂接。 功能位置:数据集成 → 数据源接入 → 数据库设置 → 物理表管理 → 查看表结构 → 关联字典 配置表5:字段映射挂接 配置项 填写内容 说明 目标物理表 customer_info 需要挂接标准的数据表 目标字段 gender 需要标准化的字段(如性别字段) 关联字典 从国标/行标/地标/团标/规范/制定标准中选择 选择已解构的代码集——如选择"性别代码"字典表 关联效果 0→未知, 1→男, 2→女 系统在展示数据时自动将存储值转换为业务名称 关键机制说明: 第一,关联字典后,在数据质量模块的问题数据查看界面中,系统会自动将原始代码值翻译为业务名称。比如gender字段存的是"1",界面展示为"男"——让业务人员也能直接看懂问题数据,而不需要先查代码表。 第二,与关联字典同步的是业务标识字段配置。当把customer_name设为业务标识字段后,问题数据列表中优先展示客户姓名而非一个ID值。这一点在实际使用中非常重要——"客户ID=1024的gender字段不达标"和"XX科技股份有限公司的性别字段不达标",后者让业务部门能够直接认领问题。 第三,需要特别说明的是,关联字典在数据中台上是一个"翻译"层——它改变的是数据在界面上的展示方式,不修改原始存储值。真正的标准合规检查——"这个字段的值到底对不对"——在下一步的质量稽核中执行。 3.5 第五步:质量稽核配置——从"挂接"到"检查" 功能位置:数据治理 → 数据质量 → 评测模型管理 前四步解决了"标准是什么"和"标准挂在哪儿"的问题。第五步解决的是"数据到底有没有遵守标准"——以已定义的数据标准为参照,配置自动化质量稽核规则,持续检查实际数据。 配置表6:引用完整性检查规则配置 配置项 填写内容 说明 评测模型 客户信息质量评测 按业务主题组织规则的容器,一个模型下可包含多条规则 评测对象 customer_info表(治理库DW) 实际数据所在的物理表 规则名称 性别代码引用完整性检查 规则名称建议包含"字段名+检查类型",便于问题追踪时快速定位 规则类型 引用完整性检查 龙石数据中台提供12类质检规则。引用完整性检查专门用于校验字段值是否符合引用的标准代码集 检查字段 gender 需要稽核的字段 引用类型 标准代码集 从国/行/地/团/规范和制定的标准中选择已解构的代码集 键值匹配 代码 / 名称 选择按代码值匹配还是按代码名称匹配,取决于物理表中实际存储的是什么 规则权重 高 影响问题数据的排序和处理优先级 错误描述 "性别字段存在非标准值(当前值'X'不在GB/T 2261.1性别代码标准范围内),影响客户画像分组统计" 用业务语言回答三个问题:①什么问题②影响什么③指向修复方向 修复建议 请在数据标准模块确认标准字典后,在源系统CRM中批量修正 可操作的具体建议,而非"请检查"式的空泛指引 关键特性:引用完整性检查规则直接引用数据标准模块的代码集定义。这一设计的实际价值在于——当国家标准更新(比如新增了一个代码值),质检规则自动同步,不需要手动逐条修改规则。这是标准定义→标准执行的关键联动链路。 配置表7:评测任务调度建议 配置项 推荐值 说明 首次执行 手工触发 先手动跑一次,对着问题清单逐条确认"真问题还是误报",确认无误后再设自动 日常监控 重复执行→按天,每天6:00 每天凌晨自动扫描前一天的增量数据 注意事项 规则配好后先用"抽检"按钮验证 避免半夜定时任务因规则参数错误产生大量误报 四、两种差异化场景的快速展开 以上是企业侧客户主数据的标准落标场景。标准模块的能力不仅适用于企业数据治理,在政务和工业场景中同样有效。 4.1 政务场景:有标贯标,无标立标 某区大数据中心面临"制度规范缺失、标准体系分散、质量问题频发"的局面,数据共享时各部门对同一个字段的理解不一致导致审批流程反复打回。该中心按照"有标贯标、无标立标"的原则推进标准建设:国家标准(GB/T)已有的直接通过标准登记功能引用,不需要重新定义;没有现成标准的,通过数据元制定功能自定义区级数据元标准。经过多轮迭代,共制定200余项区级数据元标准,发布了《数据标准管理实施细则》,沉淀了5,000个质量规则,200个高频数据资源准确率达到100%。 4.2 工业场景:标准先行,集成才有意义 某大型化工企业MES(生产执行系统)、ERP、CRM三套系统物料编码不统一,销售预测与生产排产长期脱节。项目团队做的第一件事不是接数据,而是建立企业级数据标准体系——统一物料、产品、工序等核心业务对象的编码规则和指标口径。通过标准登记导入化工行业标准,结合企业现状通过"规范管理"自定义内部规范,再通过数据元制定为每个字段建立完整的属性定义。标准体系建好后,后续数据集成才有了共同的参照系。实施后库存周转率提升28%,订单交付及时率提升至91%。 五、稽核执行后的实际效果 以客户信息表为例,部署引用完整性检查规则后首次全量扫描,通常会看到类似的问题分布:性别字段可能有800余条含非标准值(如"未知""0""X"),占总量约0.1%;客户等级字段可能有1,200余条不在标准代码集中——ERP存的是"A/B/C",而标准定义了"战略/重点/普通"三种规范写法。 龙石数据中台在多个项目中通过标准自动落标机制,将字段合规率从60%提升到95%以上。核心变化不在于多了几条稽核规则,而在于标准不再只是文档——它变成了每天自动执行的校验逻辑。业务部门新增数据、接入新系统时,标准一致性由平台自动保障,治理团队不需要手工核对每一批新入库的数据。 六、项目避坑:三个最常踩的坑 标准落标操作的路径看似清晰,但在实际项目中仍有几个容易踩进去的坑。 坑一:把标准定义当成标准执行 这是最常见的情况。团队花了两周把国标、行标全部登记完了,数据元也定义了几十个,代码集也导入了。配置完成,文档归档,项目汇报时PPT上写着"数据标准体系已建立"——但实际数据接入后,没有人去配置关联字典,也没有建稽核规则。标准在平台里安静地躺着,和每天跑的数据流完全脱节,除了阶段性汇报时被翻出来引用一下,没有任何实际作用。解法很明确:标准建设必须三步闭环——①定义标准 → ②字段挂接(关联字典) → ③配置稽核规则(引用完整性检查)。三个动作缺一不可。做完②和③之后,标准才真正进入了数据流转的日常轨道。 坑二:标准登记贪多求全 项目初期一口气把能找到的国标、行标、地标全部登记解构了,解构审核周期被拉得很长,治理团队被标准维护工作淹没,真正需要用的那几条标准反而被淹没在海量条目里。标准不在多,在真的有人在用。建议先从当前最影响业务的2-3个核心数据域入手——比如客户域、产品域、订单域。一个域跑通全流程(登记→解构→数据元→挂接→稽核),再扩展下一个域。 坑三:错误描述写成了技术语言 稽核规则的错误描述直接写成"gender字段不满足引用完整性检查,标准代码集GB/T 2261.1无匹配值"。数据治理团队的人看得懂,但业务部门的负责人看不懂——问题流转到业务侧后被搁置,因为没人知道这条报错到底在说什么、影响什么、谁来修。解法是把错误描述翻译成业务语言,明确回答三个问题:什么问题("性别字段存在非标准值")、影响什么("影响客户画像分组统计")、怎么修("请在数据标准模块确认标准字典后,在源系统CRM中批量修正")。一条好的错误描述,应该让业务负责人看到后就知道该找谁、该干什么。 七、小反转:标准落标不是增加工作量,而是降低长期成本 写到这里,可能会有读者产生一个疑问:数据已经在跑了,我还要花时间去定义数据元、配代码集、建稽核规则,这不是在给一个已经运转的系统"加负载"吗? 实际情况正好相反。我们来看一个真实例子:某建筑装饰集团旗下有200余家子公司,同一根"镀锌方管40×60"在三个不同系统里有三种不同的编码和名称。每接入一个新系统、每出一张新报表,治理团队都要做一轮手工的字段映射和数据清洗。标准缺失的代价不是一次性投入,而是持续放大——系统越多、数据量越大,手工对齐的成本越高。这些重复性劳动没有积累效应,不会因为做了十次就自动消失。 标准落标本质上是在降低长期运维成本。标准在前端定义好,后续数据接入时自动对齐;稽核规则在流转中自动执行,问题数据在源头就被标记。治理团队的时间从反复做"字段映射"和"问题追溯"中释放出来,转向真正有价值的资产建设和数据运营。标准落标的投入是一次性的体系建设成本,而它节省的是每个月都在重复发生的运维开销——这才是完整的经济账。 八、常见问题(Q&A) Q1:标准代码集和自定义字典有什么区别?什么时候用哪个? 标准代码集来自国家标准或行业标准等权威来源,通过标准登记→标准解构功能进入平台。自定义字典是组织内部自行定义和维护的代码集(如订单状态、客户等级等业务特定取值)。选择原则很简单:有外部权威标准的字段优先引用标准代码集——既减少维护工作量(标准更新由平台跟踪),也提升数据对外共享时的互认程度。没有现成标准的业务字段,用自定义字典。 Q2:数据标准制定后,多久能在稽核中生效? 数据元制定并发布后,在配置引用完整性检查规则时即可被选中引用。如果已经建立了评测任务并设为定时执行,规则保存后下一次任务调度窗口就会生效——通常是下一个凌晨的6:00。 Q3:稽核规则多久跑一次合适?会不会影响系统性能? 首次建议手工触发跑通验证,确认规则无误后改为按天定时执行(推荐每天凌晨6:00)。质量评测是数据同步之后独立运行的旁路任务,不阻塞数据入库流程。对于千万级以上的大表,建议通过评测对象的过滤条件限定数据范围或分批评测,避免单次任务运行时间过长。 Q4:历史存量数据怎么批量做标准映射? 如果存量数据的字段值与标准代码集不一致(如历史数据中性别存的是"男/女"文本而标准代码集存的是"1/2"编码),建议在数据清洗流程中增加一个转换步骤——通过清洗流程开发组件将历史数据映射到标准代码值上。需要说明的是,关联字典只做"翻译"展示,不修改原始数据存储值,因此不能依赖关联字典来解决存量数据与标准不一致的问题。 Q5:国家标准更新后,已配置的映射和稽核规则会受影响吗? 标准登记模块支持"代替已有标准"操作——新标准发布后,将原标准代码集复制到新标准下,修改差异项,审核通过后新标准生效。引用完整性检查规则如果引用的是旧标准代码集,需要手动更新为新标准代码集版本。这一环节建议在标准变更时同步检查关联的稽核规则,避免旧的质检规则继续按老标准运行。 Q6:编码规则中的流水号达到最大值后会怎样? 龙石数据中台的编码规则管理中设置了流水号最大值。当流水号达到最大值后,会从"流水码起始值"重新开始循环。如果该编码字段设置了不允许重复的约束,重新生成时会报错——此时需要调整最大值范围或重新规划编码规则。 九、落标的终局:从"人工核对"到"自动运转" 数据标准的制定是序曲,落标才是治理的正文。 这一整套操作路径——标准登记→标准制定→字段挂接→质量稽核——背后是龙石数据"理采存管用"方法论中"管数据"环节的核心实践。DCMM(数据管理能力成熟度模型,GB/T 36073-2025)在数据标准能力域中明确区分了"制定标准"和"执行标准"两个层次,而理采存管用把DCMM的评估框架变成了可操作的工程路径:不是把标准写成文档放在共享盘里等待下一次审计,而是让标准在数据流转中每天自动执行。 真正让标准扎根的,从来不是一次性的标准定义工作,而是一个持续运转的机制——标准有地方管理、字段有标准可依、数据有稽核对标、问题有责任闭环。平台让这个机制自动化运转,治理团队从"人工核对"中解脱出来,把精力投入到体系建设和资产运营中去。这才是数据标准落标的终局。 参考来源: DCMM(GB/T 36073-2025)数据管理能力成熟度模型、GB/T 19488.2-2008 电子政务数据元 第2部分:公共数据元目录、GB/T 2261.1 人的性别代码、GB/T 4754-2017 国民经济行业分类